
PyTorch中的最小化与最大化
PyTorch中的最小化与最大化
提问于 2018-06-12 04:42:50
我想知道如何在PyTorch中对以下数学运算采取梯度步骤(A、B和C是参数为而不是重叠的PyTorch模块)
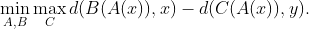
这与生成性对抗性网络(GAN)的成本功能有些不同,所以我不能使用现成的GANs的例子,而且我在尝试将它们调整到上面的成本时被困住了。
我想到的一种方法是构造两个优化器。优化器opt1具有模块A和B的参数,优化器opt2具有模块C的参数。
- 采取步骤,使C的成本函数最小化
- 再次使用相同的输入运行网络,以获得成本(和中间输出)。
- 在A和B方面迈出一步。
我确信,它们肯定是使用PyTorch (可能使用一些detach操作)更好的方法,可能不会再次运行网络。任何帮助都是非常感谢的。
回答 1
Stack Overflow用户
发布于 2020-07-28 17:04:17
是的,不经过两次网络是可能的,这在数学上既浪费资源,又是错误的,因为权重已经改变了,所以损失了,所以你引入了一个延迟,这可能是有趣的,但不是你想要达到的。
首先,如您所说,创建两个优化器。计算损失,然后调用backward。此时,参数A、B、C的梯度已被填充,所以现在您只需调用step方法来使损失最小化,而不是调用最大化损失的方法。对于后一种情况,需要反转叶参数张量C的梯度符号。
def d(y, x):
    return torch.pow(y.abs(), x + 1)

A = torch.nn.Linear(1,2)
B = torch.nn.Linear(2,3)
C = torch.nn.Linear(2,3)

optimizer1 = torch.optim.Adam((*A.parameters(), *B.parameters()))
optimizer2 = torch.optim.Adam(C.parameters())

x = torch.rand((10, 1))
loss = (d(B(A(x)), x) - d(C(A(x)), x)).sum()

optimizer1.zero_grad()
optimizer2.zero_grad()

loss.backward()
for p in C.parameters():
    if p.grad is not None: # In general, C is a NN, with requires_grad=False for some layers
        p.grad.data.mul_(-1) # Update of grad.data not tracked in computation graph

optimizer1.step()
optimizer2.step()注:如果结果是正确的,我会用数学方法检查,而不是,但我假设是正确的。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/50809367
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号