
Neo4j大容量导入不适用于大数据集
我以前使用过新4j的批量导入作为一个中小型原型数据集,它的工作就像一种魅力。我现在使用它导入整个数据集,该数据集由~100 GB分割成7个csv文件:4个节点csv文件(每个文件具有不同的标签)和3个边缘csv文件。报头是每个文件的第一行,我使用以下命令(在Windows10上的Neo4j桌面终端中):
SET DATA=D:\Neo4jdb\data

.\bin\neo4j-admin import ^

--mode=csv ^

--database=full_kb.db ^

--ignore-duplicate-nodes true ^

--nodes %DATA%\nodes_assoc.csv ^

--nodes %DATA%\nodes_article.csv ^

--nodes %DATA%\nodes_term.csv ^

--nodes %DATA%\nodes_chunk.csv ^

--relationships %DATA%\edges_IN_ASSOC.csv ^

--relationships %DATA%\edges_IN_ARTICLE.csv ^

--relationships %DATA%\edges_IN_CHUNK.csv
节点在大约40分钟后成功导入,但是一旦排序开始,CPU使用率就会最大化(恒定值为100%),并且已经持续了超过24小时(从技术上讲,它并没有卡住,因为CPU的使用率仍然是100%。但是,我无法再看到状态,因为由于cpu使用率很高--可能是一个错误--终端都是空的。
我遇到了similar queries on SO,它的回答是“因此,理想情况下,总是为每种类型的节点和rel提供独立的文件,结果最快(至少在我的测试中是这样)”,这正是我的数据的结构方式。这也不同于this SO question,因为节点导入成功,而且我还验证了我的文件中的引号--这就是这个问题的答案。每个文件的标题如下:
nodes_chunk.csv (30 GB)
id:ID(chunk),:LABELnodes_term.csv (15 GB)
id:ID(term),:LABELnodes_article.csv (5GB)
id:ID(article),title,filename,:LABELnodes_assoc.csv (11 GB)
id:ID(assoc),:LABELedges_IN_CHUNK.csv (15 GB)
:START_ID(assoc),:END_ID(chunk)edges_IN_ARTICLE.csv (2GB)
:START_ID(chunk),:END_ID(article)edges_IN_ASSOC.csv (2GB)
:START_ID(term),:END_ID(assoc)更新:
我已经从每个文件中删除了副本,以确保这不是一个限制步骤,但问题仍然存在。资源现在不再受到限制,因为CPU和内存的使用率低于30% (与以前使用CPU 100%相比),而且磁盘也不使用。进度条完全没有显示任何改进,因此导入根本没有进展。
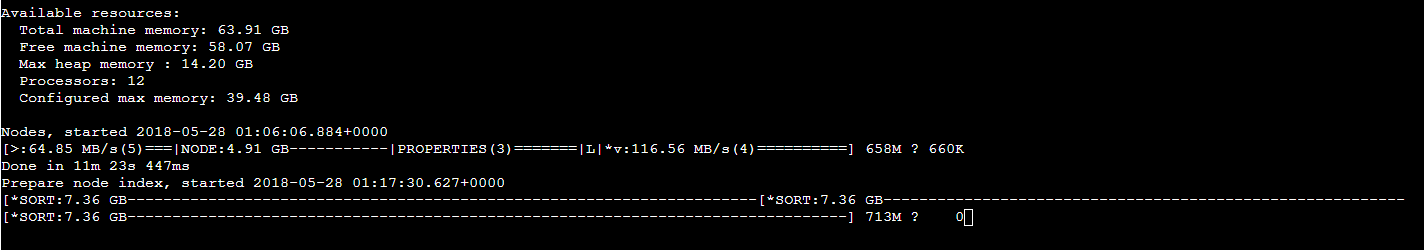
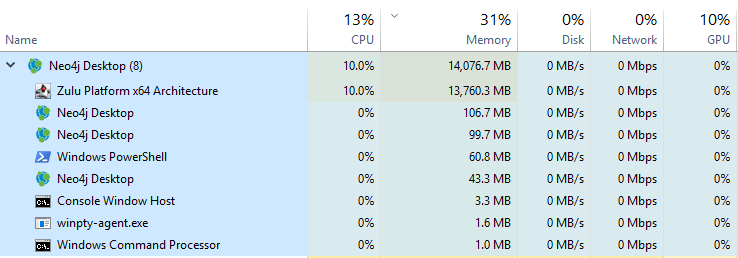
更新2: I已经将neo4j更新为3.4,因为发布说明状态下,批量导入已经被进一步优化,以便更快地导入,但是问题仍然存在。对于上述1/4节点文件,在达到50%后,移动1%需要几个小时。
回答 1
Stack Overflow用户
发布于 2018-12-20 12:17:58
我也有过类似的问题。解决方案取决于duplicated_nodes。我对它们进行了预处理,以消除任何重复,而且效果很好。我希望这是有用的
https://stackoverflow.com/questions/50552882
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号