
在不同单元格中以任意顺序搜索三个单词“文本”的公式
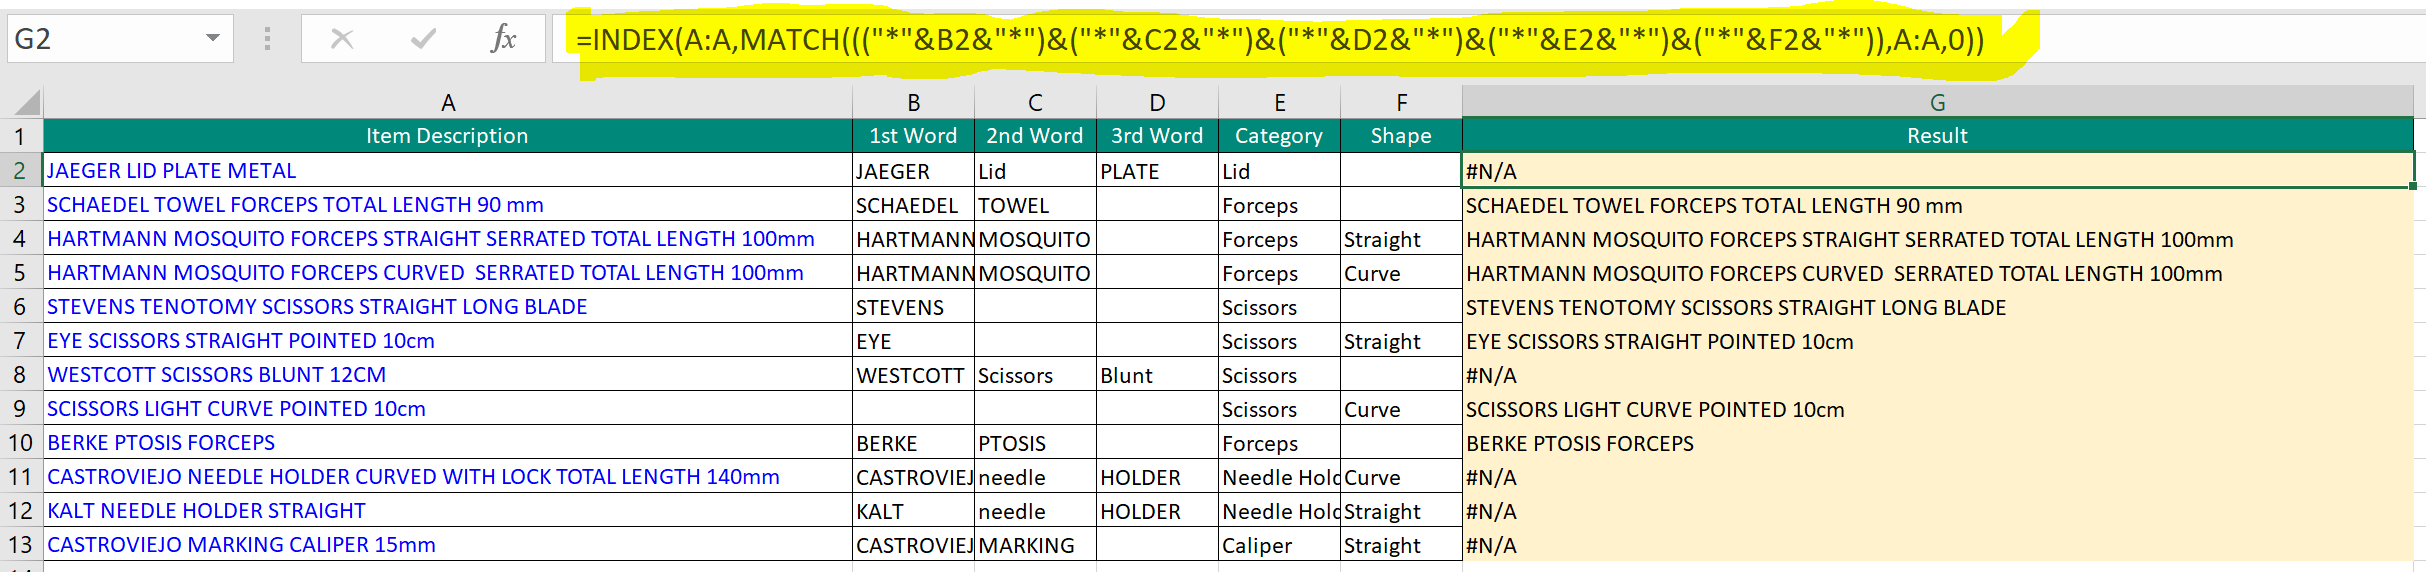
请看附图。我有一长串的项目,我已经创建了一个常见的关键字在该列表中搜索。我用这个公式:
=INDEX(A:A,MATCH((("*"&B2&"*")&("*"&C2&"*")&("*"&D2&"*")&("*"&E2&"*")&("*"&F2&"*")),A:A,0))搜索过程中的问题与我输入的顺序相同。如果单元格中的单词序列与我公式中的顺序不同,就会产生错误,这是有意义的。
有没有一种方法,我可以搜索三个或更多的词,是存在于任何单元格在任何顺序?
如有必要,我愿意使用VBA。
我的搜索结果:
回答 2
Stack Overflow用户
发布于 2018-05-23 00:17:43
下面是用户定义的函数:
Public Function indexMX(rng As Range, pat1 As Range, pat2 As Range, pat3 As Range, pat4 As Range, pat5 As Range) As Variant
    Dim r As Range, rngx As Range, s(1 To 5) As String, Kount As Long, j As Long

    s(1) = pat1.Value
    s(2) = pat2.Value
    s(3) = pat3.Value
    s(4) = pat4.Value
    s(5) = pat5.Value

    Set rngx = Intersect(rng, rng.Parent.UsedRange)

    For Each r In rngx
        v = r.Value
        Kount = 0
        For j = 1 To 5
            If InStr(1, v, s(j)) > 0 Or s(j) = "" Then Kount = Kount + 1
        Next j
        If Kount = 5 Then
            indexMX = v
            Exit Function
        End If
    Next r
    indexMX = "no luck"
End Function
下面是它的用法的一个例子:
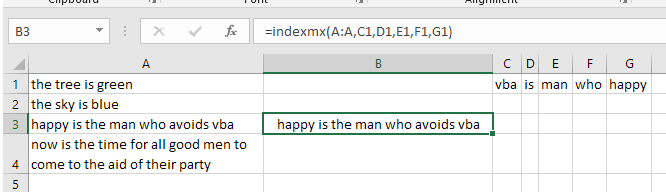
正如您所看到的,我们给UDF()列的地址和五个关键字的地址,UDF()找到包含所有五个单词的第一个条目。
如果关键字为空,则不使用该关键字。(因此,如果您只想搜索两个关键字,则将其他三个关键字保留为空白)。如果没有找到匹配项,则返回短语,不返回运气。
用户定义函数(UDF)非常容易安装和使用:
- ALT-F11打开VBE窗口。
- ALT-I ALT-M打开一个新模块。
- 粘贴内容并关闭VBE窗口
如果您保存了工作簿,那么UDF将与它一起保存。如果您在2003年晚些时候使用Excel版本,则必须将该文件保存为.xlsm而不是.xlsx。
要删除UDF,请执行以下操作:
- 打开上面的VBE窗口
- 清除代码
- 关闭VBE窗口
要使用Excel中的UDF:
=myfunction(A1)
要了解有关宏的更多信息,请参见:
http://www.mvps.org/dmcritchie/excel/getstarted.htm
和
http://msdn.microsoft.com/en-us/library/ee814735(v=office.14).aspx
关于联合发展基金的具体情况,见:
http://www.cpearson.com/excel/WritingFunctionsInVBA.aspx
必须启用宏才能使其工作!
EDIT#1:
若要删除区分大小写的内容,请替换:
If InStr(1, v, s(j)) > 0 Or s(j) = "" Then Kount = Kount + 1通过以下方式:
If InStr(1, LCase(v), LCase(s(j))) > 0 Or s(j) = "" Then Kount = Kount + 1Stack Overflow用户
发布于 2018-05-24 05:34:58
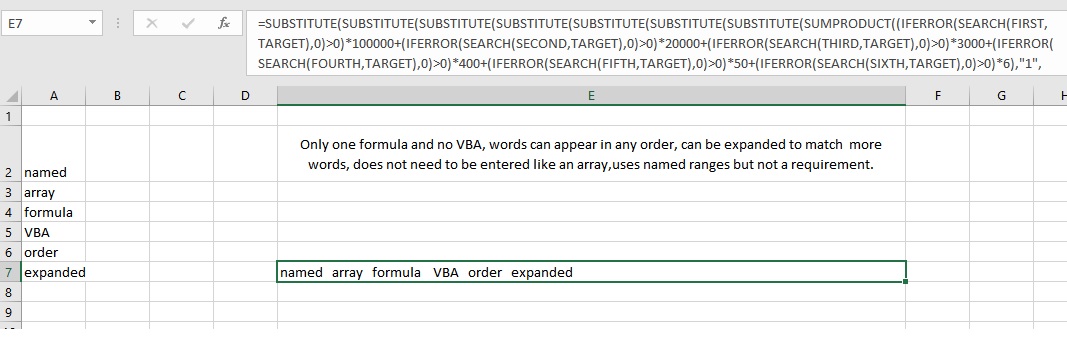
是的,单个单元格可以从不同的单元格返回三个匹配的单词。本例中的答案使用一个公式返回6个匹配项。不使用VBA和特殊数组函数。
这就是公式:
=SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUMPRODUCT((IFERROR(SEARCH(FIRST,TARGET),0)>0)*100000+(IFERROR(SEARCH(SECOND,TARGET),0)>0)*20000+(IFERROR(SEARCH(THIRD,TARGET),0)>0)*3000+(IFERROR(SEARCH(FOURTH,TARGET),0)>0)*400+(IFERROR(SEARCH(FIFTH,TARGET),0)>0)*50+(IFERROR(SEARCH(SIXTH,TARGET),0)>0)*6),"1",FIRST&DELIM),"2",SECOND&DELIM),"3",THIRD&DELIM),"4",FOURTH&DELIM),"5",FIFTH&DELIM),"6",SIXTH&DELIM),"0","")你注意到指定的范围了吗?第一、第二、第三等是单个的细胞,每个细胞都有一个单词。我们正试图在目标内部找到这些词。如果我们找到这些单词,我们将把它们写在这个保持这个公式的单元格中,每个单词将被DELIM分隔开。
范围是可选的。在下面的图片中,您将看到单元格A2包含单词"named“。这是我们要查找的六个单词中的第一个,它可以在公式中表示为first = "A2“= "named”,您将看到第一次出现两次。您可以将其替换为“命名”,单元格A2将变为空白,但公式的功能不会改变。
甚至目标也是可选的。它可以写成E1或者逐字打印出来。我不知道为什么会有人这么做..。但这是有可能的。
DELIM位于单元格( cell B2 ),是一个双空间。
现在来解释一下它是如何工作的
搜索(搜索什么?,搜索哪里?)这将负责确定是否存在匹配。如果您了解命名范围,那么您已经知道了语法。返回目标中第一个字母的位置。在这个公式中,它总是1,如果找不到它,那么这个数字就是0。
IFERROR(value,value)尝试执行操作。如果成功,则显示结果。如果出现错误,则显示第二个结果。这个公式中的每个IFERROR实际上都是相同的:它在目标内部搜索IFERROR(SEARCH(FIRST,TARGET),0),试图找到第一个单词。如果找到的结果是1,如果没有找到,结果是0。
从这里开始变得更复杂了,让我们来回顾一下。我们给搜索打了6次电话。每一次我们想要找到的单词,我们总是在寻找目标。如果找到匹配,结果将是1,如果不匹配,则为0。具有讽刺意味的是,我们人类可以把它放在一起看比赛,但是公式不能确定在没有更多信息的情况下匹配了哪些单词。
SUMPRODUCT接受两个或多个数组的乘积(乘法)的和(加法)。
将两个数组相乘得到乘积a, b, c * e, f, g = ae, bf, cg takethe sum of the product to get the SUMPRODUCT ae + bf + cg` `
这是最容易想到的价格和数量。如果一个数组是一组项目的价格,另一个数组是同一组项目的数量,那么两个数组相乘将创建一个新的数组,其中每个元素都是在组中购买该类型所有项目的成本--总计,并将所有这些数字相加,您将为所有项目支付总成本。
在这里,我们乘上两个数组:
Qty    Price
12.0    0.3
70.0    0.1
20.0    0.4
将它们相乘以得到产品:
Qty    Price    Total
12.0    0.3     3.8
70.0    0.1     7.0
20.0    0.4     8.0
取产品之和:
Qty    Price    Total
12.0    0.3     3.8
70.0    0.1     7.0
20.0    0.4     8.0
                18.8 SUMPRODUCT
让我们看一看公式的一部分:
*100000+IFERROR(搜索(第二,目标),0)>0)*20000+.
很容易看出这个片段是在寻找两个单词。我们知道SUMPRODUCT想要乘和添加数组。如果你认为(IFERROR(SEARCH(FIRST,TARGET),0)>0)是一个数组,那你就对了!它不是这个词的技术意义上的数组,但它确实计算成一个值,它可以被认为是一个1x1数组,或者一个单元格。敏锐的眼睛和敏捷的智慧,可能已经注意到,在这个阵列上,我们已经提到了一些东西。这是最后的不平等!你们中的许多人都知道,你可以将数值转化为布尔值,方法是用一个不等式来测试它们。所以让我们来评估..。搜索第一个内部目标= 1,因为第一个=“命名”,它在后面的目标waaaaaaay,因为它不是一个错误,我们得到保留1。接下来,我们做的不等式1>0=真1大于零,并计算为真。
这就是我们现在要做的
SUMPRODUCT((TRUE*100000+IFERROR(SEARCH(SECOND,TARGET),0)>0)*20000+....你现在能识别数组了吗?我们知道TRUE是一个数组,一个1x1。您知道,IFERROR位一直到不等式,也是一个数组。让我们来评估一下.从数学上讲,我们仍然应该从左到右工作,但是相信我,如果我们让它滑动一次,我们会没事的。
IFERROR(SEARCH(SECOND,TARGET),0)>0) SECOND = "array" = 1 = TRUE你跟着我的短手吗?如果你不先回去练习,直到你明白为止,那也没关系。
插入这个值会给我们这样的结果
SUMPRODUCT(TRUE*100000+TRUE*20000+...SUMPRODUCT是乘积(乘法)的和(加法),所以我们要把乘积相加
SUMPRODUCT = (TRUE * 100000) + (TRUE * 20000)记住,从1>0变成真是多么容易。我们“把所有的布尔值都提高到真,”等于1,这是一个有趣的事实,-1也等于真。如果你见过这样的公式,里面有双负数(好吧,让我们回到正轨
SUMPRODCUT = 1 * 100000 + 1 * 20000+....
SUMPRODCUT =  100000 + 20000+....
SUMPRODCUT =  120000+.....
我知道你一直在问那些数字。十万?十万是做什么用的?我一直故意忽略它,直到它变得方便谈论它。现在很方便。去看看那些公式,你就会发现一个模式。这些数字是一个递减的序列。任何做过按位逻辑的人都能看出这是怎么回事。我的时间不多了,所以我就直截了当了。假设假设每个单词都匹配在一起。你最终会
SUMPRODUCT = 100000 + 20000 + 3000 + 400 + 50 + 6
SUMPRODCUT = 123456
123456你在跟我开玩笑吗?不,我不是。我们快完成了,如果你还和我在一起,那你就开车回家吧。
我们前面有一大群代课老师,我们得把他们赶走。
我们还需要与:"1",FIRST&DELIM),"2",SECOND&DELIM),"3",THIRD&DELIM),"4",FOURTH&DELIM),"5",FIFTH&DELIM),"6",SIXTH&DELIM),"0","")抗衡
对我们来说,谢天谢地,它们是同一个问题的一部分。我们从中间一直往前走。
SUBSTITUTE(SUBSTITUTE(text, old text, new text)
SUBSTITUTE(SUBSTITUTE("123456","1", FIRST & DELIM),"2",SECOND & DELIM)....
请记住,在顶部,DELIM指的是一个有两个空格的细胞。可以将每个DELIM替换为“”或任何其他所需的分隔符。
SUBSTITUTE(SUBSTITUTE("123456","1", "named" & "  "),"2",SECOND & DELIM)...
SUBSTITUTE("named  23456","2",SECOND & DELIM)...
SUBSTITUTE("named  23456","2","array"& "  ")...
("named  array  3456")... and so on.
有什么问题吗?
好了,下课了!
https://stackoverflow.com/questions/50477779
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号