
复合python3型履带刮板机
复合python3型履带刮板机
提问于 2018-05-22 06:51:42
在从行中提取数据时,下面的代码工作得很好,在我的例子中是行。我想知道如何调整它以从多个行中提取数据?
另外,我希望能够为特定的列指定使用哪个divTag类(请参阅下面的代码)。
类似于行1,2使用的:
divTag = soup.find("div", {"class": "productsPicture"})对于行4、5使用:
divTag = soup.find("div", {"class": "product_content"})如果这对你们有意义的话。
from bs4 import BeautifulSoup
import requests
import csv

with open('urls.csv', 'r') as csvFile, open('results.csv', 'w', newline='') as results:
reader = csv.reader(csvFile, delimiter=';')
writer = csv.writer(results)

for row in reader:
    # get the url
    url = row[0]
    print(url)

    # fetch content from server

    try:
        html = requests.get(url).content
    except requests.exceptions.ConnectionError as e:
        writer.writerow([url, '', 'bad url'])
        continue

    # soup fetched content
    soup = BeautifulSoup(html, 'html.parser')

    divTag = soup.find("div", {"class": "productsPicture"})

    if divTag:
        # Return all 'a' tags that contain an href
        for a in divTag.find_all("a", href=True):
            url_sub = a['href']

            # Test that link is valid
            try:
                r = requests.get(url_sub)
                writer.writerow([url, url_sub, 'ok'])
            except requests.exceptions.ConnectionError as e:
                writer.writerow([url, url_sub, 'bad link'])
    else:
writer.writerow([url, '', 'no results'])urls.csv样本:
https://www.tennis-point.com/index.php?stoken=737F2976&lang=1&cl=search&searchparam=E705Y-0193;
https://www.tennis-point.com/index.php?stoken=737F2976&lang=1&cl=search&searchparam=E703Y-0193;
https://www.tennis-point.com/index.php?stoken=737F2976&lang=1&cl=search&searchparam=E702Y-4589;
https://www.tennis-point.com/index.php?stoken=737F2976&lang=1&cl=search&searchparam=E706Y-9093;
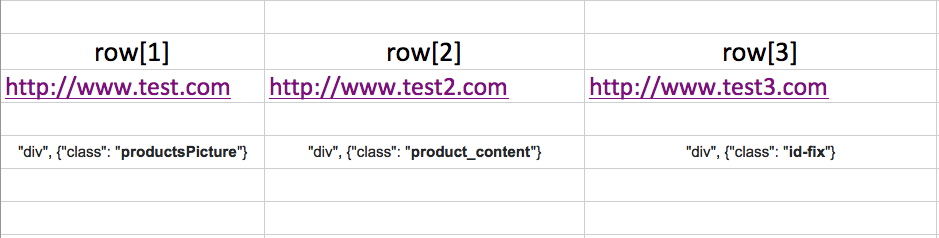
要搜索的示例类:
回答 1
Stack Overflow用户
回答已采纳
发布于 2018-05-24 10:08:25
要添加每个列find参数,可以创建一个字典,将索引号映射到所需的查找参数,如下所示:
from bs4 import BeautifulSoup
import requests
import csv

class_1 = {"class": "productsPicture"}
class_2 = {"class": "product_content"}
class_3 = {"class": "id-fix"}

# map a column number to the required find parameters
class_to_find = {
    0 : class_3,    # Not defined in question
    1 : class_1,
    2 : class_1,
    3 : class_3,    # Not defined in question
    4 : class_2,
    5 : class_2}

with open('urls.csv', 'r') as csvFile, open('results.csv', 'w', newline='') as results:
    reader = csv.reader(csvFile)
    writer = csv.writer(results)

    for row in reader:
        # get the url

        output_row = []

        for index, url in enumerate(row):
            url = url.strip()

            # Skip any empty URLs
            if len(url):
                #print('col: {}\nurl: {}\nclass: {}\n\n'.format(index, url, class_to_find[index]))

                # fetch content from server

                try:
                    html = requests.get(url).content
                except requests.exceptions.ConnectionError as e:
                    output_row.extend([url, '', 'bad url'])
                    continue
                except requests.exceptions.MissingSchema as e:
                    output_row.extend([url, '', 'missing http...'])
                    continue

                # soup fetched content
                soup = BeautifulSoup(html, 'html.parser')


                divTag = soup.find("div", class_to_find[index])

                if divTag:
                    # Return all 'a' tags that contain an href
                    for a in divTag.find_all("a", href=True):
                        url_sub = a['href']

                        # Test that link is valid
                        try:
                            r = requests.get(url_sub)
                            output_row.extend([url, url_sub, 'ok'])
                        except requests.exceptions.ConnectionError as e:
                            output_row.extend([url, url_sub, 'bad link'])
                else:
                    output_row.extend([url, '', 'no results'])

writer.writerow(output_row)enumerate()函数用于返回对列表进行迭代的计数器惠斯特。因此,index对于第一个URL是0,对于下一个URL是1。然后,这可以与class_to_find字典一起使用,以获得搜索所需的参数。
每个URL的结果是创建3列,url,子url(如果成功)和结果。如果不需要,可以将其移除。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/50461496
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号