
熊猫:计算每小时数据的中位数,按日期分组
我正在研究一个数据集,其中包含芝加哥市内出租车乘车的数据。数据包含出租车ID、时间戳、车费等信息。数据样本以熊猫日期时间为单位,如下所示:
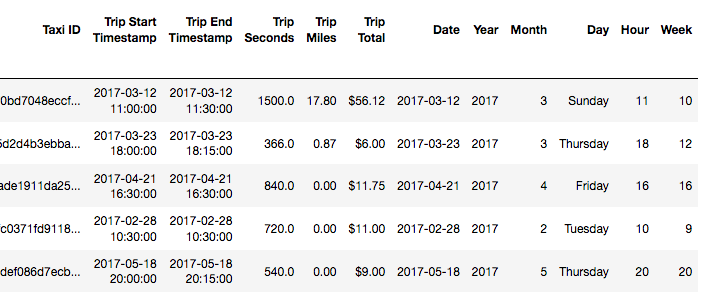
对于给定的时间框架(可以是一小时/天/周),我想要计算中位数:一个典型的出租车在整个数据集的时间框架中做了多少,并分析了它的配置文件。例如,如果我想考虑每小时的数据,我是通过在出租车ID和小时之间创建一个支点表,然后取总金额的中位数来可视化出租车收入中值随小时变化的。
taxiByHour = taxiData.pivot_table(index='Taxi ID',columns='Hour',aggfunc=sum)
taxiByHour.fillna(0,inplace=True)
taxiByHour['Trip Total'].median().plot(kind='bar', x='hour', rot = 0, color = 'green')
这显然是计算所有在该小时内在数据中发生的乘车量的中位数。如何扩展这一点,使我能够以小时为单位连续显示数据中所有时间段的中值?因此,如果我考虑一个星期的数据,我想显示每小时收入中位数的概况,24*7 = 168小时。
回答 1
Stack Overflow用户
发布于 2018-04-15 00:05:49
如果数据以行形式使用columns=["Taxi ID", "Timestamp", "Fare"],则将时间戳转换为datetime.datetime格式(如果还没有),并使其成为索引,即df.index=df["Timestamp"]。然后,您可以使用pd.DataFrame.resample与规则(在您的例子中是'H')和内置的方法(参见https://pandas.pydata.org/pandas-docs/stable/api.html#resampling)或.apply您自己的。例如:
df = pd.DataFrame([[1],[2]],index=[datetime(2017,1,1,1),datetime(2017,1,1,2)])
resampled = df.resample('H').median()https://stackoverflow.com/questions/49837177
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号