
聚集索引更新,如何仅在不同列值下更改索引?
聚集索引更新,如何仅在不同列值下更改索引?
提问于 2018-03-14 11:15:25
我有桌子,例如
Id int primary key(clustered index)
Name varchar(255)not null (non-clustered index)
..
..
Other columns
我执行存储过程作为
update table1 set table1.Name=isnull(@Name,table1.Name) ,( updating other columns) where Id=@Id;很多次,Name等于@Name;在执行计划中,我看到了
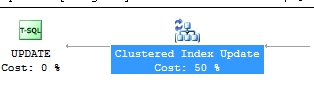
如果我将存储过程更改为
update table1 set ( updating other columns) where Id=@Id;我看到的成本:15%
问题:
我需要在两种情况下改变这个程序
- table1.Name= @Name
- 表1.名称<>名称。
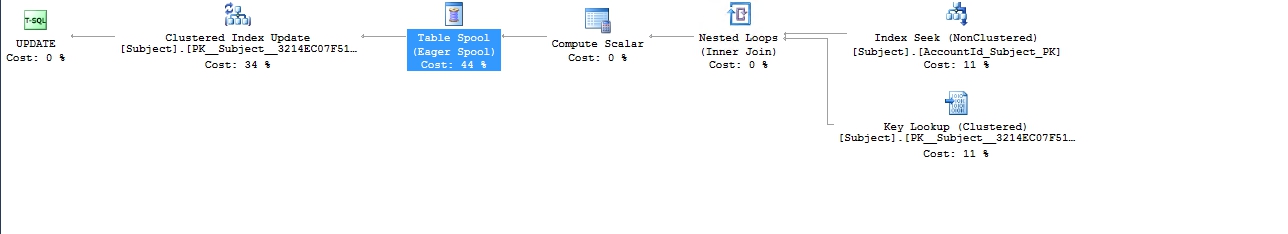
在第一种情况下,表1.名称不改变值或索引不更新,聚集索引更新成本为15%;
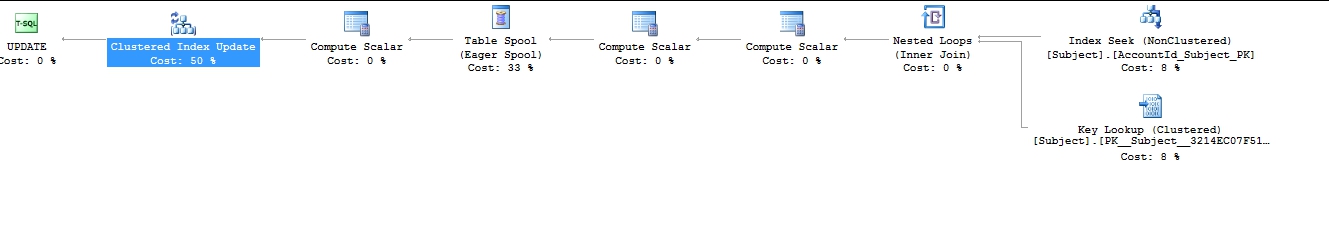
在第二种情况下,表1.名称更改值和聚集索引更新成本为50%。
更新等值时为什么要更新索引?
我不能选择“名字”来比较更新
我知道创建varchar列索引不是个好主意
更新
用更改名称列更新查询(执行CPU时间200 CPU)
更新查询而不使用更改名称列(执行CPU时间70 CPU)
更新
问题已结束
回答 1
Stack Overflow用户
回答已采纳
发布于 2018-07-14 08:06:18
为了解决我的问题,我创建了一个triger
CREATE TRIGGER [dbo].[trg_BeforeUpdateSubject]
   ON  [dbo].[Subject]
   INSTEAD OF UPDATE
AS
BEGIN
    SET NOCOUNT ON;
        declare @old_val  nvarchar(255),@new_val nvarchar(255) ;
        select
@old_val=[Name]
from deleted;
select
@new_val=[Name]
from inserted;
     if (@old_val=@new_val)
    BEGIN

        UPDATE
            Subject
        SET
            set new values for other colums,
            Subject.DLC             =   GETDATE()
        FROM
            inserted
        WHERE
            Subject.Id = inserted.Id
    END ELSE
    BEGIN
        UPDATE
            Subject
        SET
            Subject.Name = inserted.Name,
            set new values for other colums,
            Subject.DLC             =   GETDATE()
        FROM
            inserted
        WHERE
            Subject.Id = inserted.Id
    END

END
完美的工作。更新查询的平均值为90 is (CPU),旧值为200 is。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/49276316
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号