
Regex (C#) -如何匹配以冒号开头的变量名
Regex (C#) -如何匹配以冒号开头的变量名
提问于 2018-03-08 05:07:03
在我试图解析的一些表达式中,我需要区分变量名称和非变量名称。变量名以冒号开头,可以有数字(但不能以数字开头),并具有下划线。因此,有效的变量名是:
:x :_x :x2 :alpha_x // etc然后我必须找出其他的词在表达式中,而不是以冒号开头。所以在下面的表达式中:
:result = median(:x,:y,:z)变量是:result,:x,:y,和:z,而另一个非变量的单词是中间值。
我选择变量名的准则是(此方法有效):
:[a-zA-Z_]{1}[a-zA-Z0-9_]*但我想不出怎样才能得到非变量词。我的准则是:
(?<!:)([a-zA-Z_]{1}[a-zA-Z0-9_]*)问题是,匹配只排除了第一个字符之后的:例如:
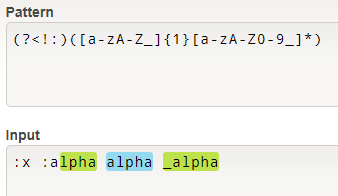
回答 2
Stack Overflow用户
回答已采纳
发布于 2018-03-08 08:23:47
(?<!:)([a-zA-Z_]{1}[a-zA-Z0-9_]*)正则表达式仍然匹配部分变量字,因为(?<!:)确保当前位置左侧没有:,然后匹配标识符而不检查单词边界。因此,在:alpha中,lpha是匹配的,因为l前面有一个字符,而不是:。
因此,通过在[a-zA-Z_]之前添加一个单词边界,这个问题很容易解决。
var words = Regex.Matches(s, @"(?<!:)\b[a-zA-Z_]\w*", RegexOptions.ECMAScript)
        .Cast<Match>()
        .Select(x => x.Value)
.ToList();见regex演示。注意,您不需要用捕获组包装整个模式。
模式细节
(?<!:)-确保当前位置左侧没有:\b-单词边界:确保当前位置的左边没有字母、数字或_。[a-zA-Z_]-匹配一个ASCII字母或_ECMAScript\w*- 0+ ASCII字母、数字或_(必须与选项一起使用,以只匹配ASCII字母和数字,并使单词边界句柄仅限于ASCII )
Stack Overflow用户
发布于 2018-03-08 05:14:22
以下模式似乎有效:
(?<=[^A-Za-z0-9_:])[a-zA-Z_]{1}[a-zA-Z0-9_]*lookbehind (?<=[^A-Za-z0-9_:])断言前面既不允许变量名中的字符,也不允许冒号。这将标记一个非变量单词的开始。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/49165794
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号