
汇总表与实时分析
我一直在研究将数据流到实时仪表板的不同方法。我过去做过的一种方法是使用星型模式/维度和事实表。这将是聚合表的实现。例如,仪表板将包含多个图表,其中之一是当天的总销售额、按产品分列的总销售额、制造商的总销售额等等。
但如果这必须是实时的呢?如果数据需要流到这些图表并实时进行分析处理,该怎么办?
我一直在寻找像Kinesis和Kafka这样的解决方案,但我可能遗漏了一些显而易见的东西。例如,请考虑以下示例。一家公司经营着一个卖馅饼的网站。该公司有一个后端仪表板,他们跟踪与销售、用户、订单等相关的所有数据和分析。
- 通过网站定制点菜
- 关系数据库(mysql)接收这个新订单。
- 图表和分析数据在后端实时更新,例如当天的总销售额,或按用户分列的全年总销售额。
如果假设需要对这些数据进行流处理,那么最好的方法是什么?汇总表似乎是显而易见的,但似乎是周期性的,而不是实时的。动感/卡夫卡感觉它适合在这里的某个地方。另一种选择是类似于Redshift,但它非常昂贵,而且可能仍然不是解决问题和规模的最佳方式。
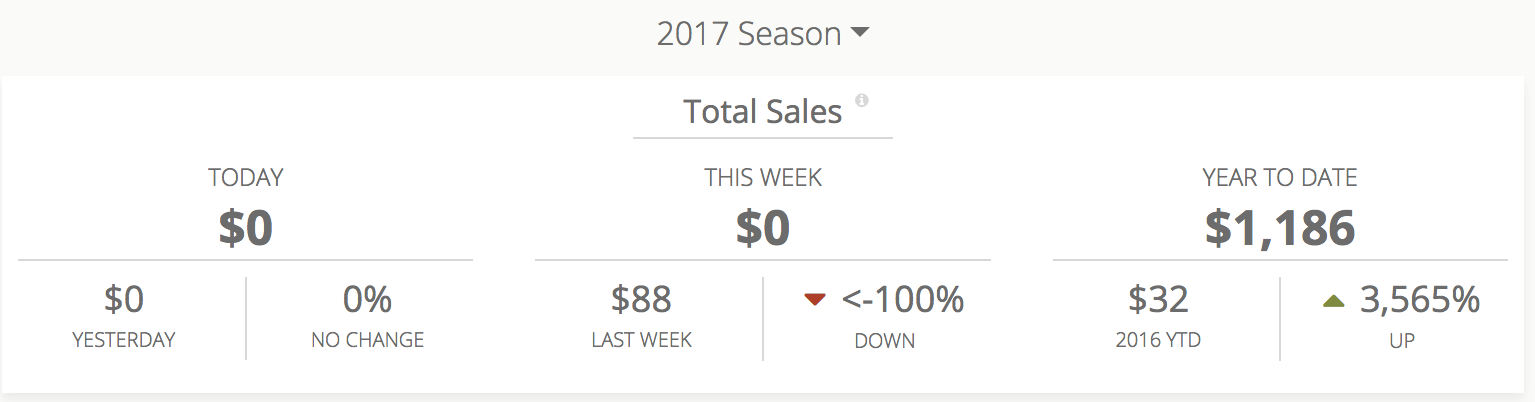
下面是一个图表的示例,它需要实时更新,当有大量行要解析时,只需执行place聚合SQL查询就会受到影响。
回答 3
Stack Overflow用户
发布于 2018-01-16 07:44:57
如果像这样的“始终是最新的”报告(销售、用户、订单等)不需要使用几乎为零延迟的流处理的实时更新,那么ROLAP类方法在工作/结果方面似乎是更理想的。
您提到了Redshift,如果您已经准备好为分析目的镜像您的数据,并且唯一的问题是价格问题,您可以考虑另一个免费的开源替代方案,它可以用于实时处理OLAP (聚合)查询(比如Yandex ClickHouse,或者在某些情况下可能是MongoDb )。
这在很大程度上取决于数据集的大小;除非您有真正需要聚合的大数据(数百GB),否则您可以继续使用mysql并使用一些技巧:
- 使用单独的带有高IOPS的从mysql服务器进行分析,只复制构建报表所需的表;可能使用另一个表引擎,更适合分析查询。设置专门用于这些查询的索引,以避免在最后几周只需要获取数字时对表进行全面扫描。
- 预先计算以前期间的指标(采用物化视图方法),并按计划(例如,每天)刷新它们,然后仅在最后一段时间将预计算的汇总与实时汇总结合起来,以获得实际的报表数据,而无需每次扫描整个事实表。
- 使用数据可视化后端,可以有效地缓存内存中的报表数据,以防止由于许多类似的查询而导致的SQL DB重载(如果为100个用户显示相同的报表或仪表板,则SQL DB负载将与1相同)。顺便说一句,我开发了这样的解决方案(不能在这里添加,因为它是商业产品)。
Stack Overflow用户
发布于 2018-01-15 06:31:39
对于大多数建筑师来说,这是一种典型的权衡。Amazon提供了典型的读取优化,但AWS堆栈是有代价的。你可以尝试使用卡桑德拉,但它有它自己的一套挑战。当谈到分析时,我从不建议使用实时,原因如下所述。
不需要实时进行分析,特别是使用MySQL
解决上述问题的方法是整理事务和分析信息。这涉及成本,但会确保你不必花时间在家务上,一旦你规模。MySQL是一种基于行的关系数据库管理系统,主要用于存储事务性数据。作为基于行的,它优化了写入,也就是说,写入几乎是实时的,因此,它在读取方面做出了妥协。当我这样说时,我指的是一个典型的分析数据集,每天记录数以百万计。如果您的数据集没有那么大,您可能仍然能够呈现显示事务性状态的图表。但既然你指的是卡夫卡,我认为数据集非常大。
一个带有可视化的实时仪表板给了一个糟糕的客户体验
考虑到上面的观点,即使你选择了一个仓库/一个经过优化的读物,你也需要了解可视化是如何工作的。如果100人同时访问仪表板,将建立100个连接到数据库,所有连接都会获取相同的数据,将它们放入内存,应用仪表板中定义的计算、参数和过滤器,调整可视化中的精化数据集,然后呈现仪表板。在此之前,仪表板将简单地冻结。构造不当的查询、索引的使用效率低下等都会使问题变得更糟。
随着数据集的增加,上述问题会越来越严重。实现你所需要的良好做法将是:
- 几乎是实时的(延迟1小时,30分钟,15分钟等),而不是一个绝对的实时系统。这将帮助您使用内存中已经获取的数据创建一个平面文件。您的仪表板将简单地读取这些数据,并且在响应过滤器等方面将非常快。此外,将避免与数据库的多个连接。
- 有一个数据结构,数据库/仓库优化为读。
Stack Overflow用户
发布于 2019-05-10 23:07:41
对于这些类型的操作分析用例--在这些情况下,数据的实时性是至关重要的--您完全正确地认为,大多数“传统”方法可能相当笨拙,尤其是随着数据大小的增加。快速概述您的选项:
历史方法(TLDR- Meh)
直到大约5年前,实际的方法看起来就像
- 建立一个主OLTP数据库,该数据库将以原始形式处理数据,并对性能或ACID属性有更严格的保证。通常这是SQL-esque的东西,即MySQL,PostgreSQL。
- 设置一个辅助OLAP数据库,用于提供脱机(也称为非面向用户的)查询。这也可能是一个SQL-esque db,但是它的模式会大不相同,因为它以丰富的形式存储数据。
- 设置一些机制,通过这些机制可以使这2保持同步。这基本上可以归结为:( a)将应用程序更改为始终同时写入数据库并执行必要的数据充实;或( b)构建独立的应用程序,从OLTP数据库读取数据,执行必要的转换和充实,并写入OLAP数据库。
- 将仪表板插入OLAP数据库,该数据库将为所需的查询类型优化模式和索引。
使用有关饼存储的示例,OLTP数据库将用于存储所有馅饼的购买,并引用客户In、账单信息、送货信息等。相比之下,OLAP数据库可能只维护一个带有模式的表。
purchase_totals(day: Date, weekNumber: int, dayOfWeek: int, year: int, total: float)虽然weekNumber、dayOfWeek和year以及技术上多余的使您的查询速度更快!在这些字段上具有适当的索引的,您的仪表板已经变成了5个简单(快速!)聚合查询以组和和,然后每周或一年以上的差异可以在客户端计算。只要你的仪表盘每分钟刷新一次,你的指尖就有近乎实时的数据。
当前方法(TLDR- Ok)
最近在计算、数据库技术和数据科学/分析方面的趋势导致了上述过程的改进,即更换了其中的某些组成部分。这些变化包括
- 使OLTP数据库、OLAP或两者都成为NoSQL数据库(Mongo通常是最流行的)。这里的好处是,您有一个更灵活的模式,如果上游的东西发生变化,它不会中断(比如,除了馅饼之外,您还开始销售蛋糕)。
- 保留SQL,但改用云提供程序解决方案,如AWS、RDS或。从根本上说,这并没有改变任何关于架构的内容,但它确实大大减轻了您的操作负担。
- 使用难以维护的ETL管道在流媒体平台(如Kafka或AWS )上充当OLAP和OLTP之间的中间层。
- 在规划如何执行ETL时,使用专用工具进行数据清理和转换。
- 在OLAP之上使用专用的可视化工具(想想塔布洛)
- 使用基于拉的方法将数据直接从OLTP db或应用程序中获取,而不是等待它最终到达OLAP。这对于在线服务是有帮助的,因为它实际上为您提供了所需的数据,并确认该服务处于正常运行状态(因为它只满足了您的数据请求)。像普罗米修斯这样的系统现在非常流行。
https://stackoverflow.com/questions/48255747
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号