
R中按群划分的彩色RDA向量
我在R中绘制了一系列RDA,每个RDA都有10+环境向量。每个环境变量都属于5个类别之一。我想要向量颜色来反映这些类别。我在某种程度上以贫民区的方式制作了原始的黑白情节,然后用Powerpoint (超级耗时)对其进行跟踪,但这里面有很多固有的问题,但至少看起来不错。这是那个图,注意矢量颜色。
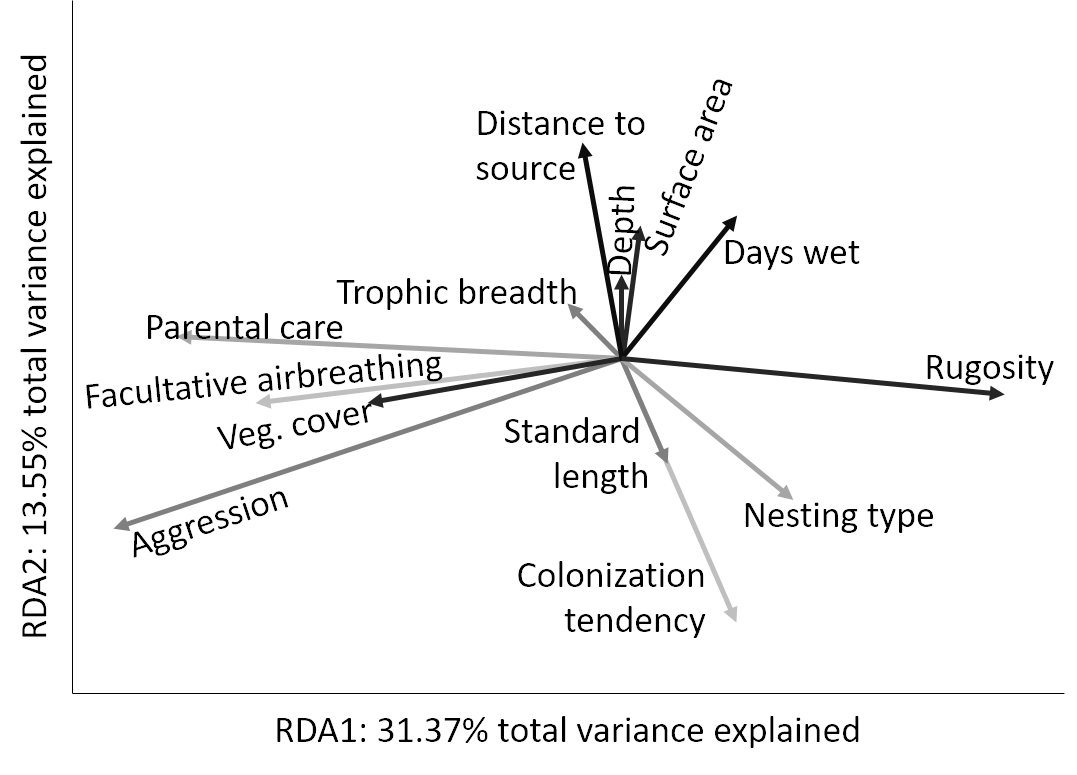
我想要我的输出是一个R本地的情节。我用来制作基本地块的地块当前是:
#download the data#
env<- read.csv("environmenta data.csv")
bio<- read.csv("bio data.csv")

#break out the groups of environmental vectors#
#these are purley for example#
group1<-as.matrix(subset(env,select=c(a,b,c))
group2<-as.matrix(subset(env,select=c(d,e,f,h))
group3<-as.matrix(subset(env,select=c(g))
group4<-as.matrix(subset(env,select=c(j,k,l,o))
group5<-as.matrix(subset(env,select=c(m,n,))

#run the RDA#
rda1<-rda(bio,env)

#Plot it#
plot(rda1,type="n",bty="n",main="",
     xlab="XX% variance explained",
     ylab="XX% variance explained",
     col.main="black",col.lab="black", col.axis="white",
     xaxt="n",yaxt="n")
#points(rda1,display="species",col="gray",pch=20)
#option to display species points
#text(rda2,display="species",col="gray")
#option for species labels

points(rda1,display="cn",col="black",lwd=2)#<<< guessing this is the key statement for my issue, but not sure
text(rda1,display="cn",col="black",cex=0.5)
我假设答案就在这一点上-->col=“.”命令,但我不知道如何按组告诉它子集。任何和所有的帮助都将不胜感激。
回答 2
Stack Overflow用户
发布于 2017-12-07 19:28:00
library(vegan)

#DATA
data(varespec)
data(varechem)
env = varechem
bio = varespec
rm(list = c("varechem", "varespec"))

#Assign colors based on groups for the columns of env
groups = rep(c("red", "blue"), length.out = NCOL(env))

rda1 = rda(X = bio, Y = env)
plot(rda1, type = "n")
points(rda1)
text(rda1, display = "bp", col = groups)Stack Overflow用户
发布于 2017-12-12 01:48:57
这里有几个问题:
- 绘制双情节分数,和
- 按
plot.cca缩放双图分数
后者并不那么重要,如果你只是绘制双情节分数,但这种绘图的一般解决方案需要,我们认为,其他分数也可能需要绘制。
下面是一个可复制的示例,它使用内置于
library('vegan')
data(varespec, varechem)
现在我们放了一个愚蠢的排序(别在家里这么做,伙计们)
ord <- rda(varespec ~ ., data = varechem)接下来,提取双情节分数。
bp <- scores(ord, display = 'bp')并假设我们有一个变量,其中包含我们希望将每个双情节分数分配给的组。
f <- factor(sample(1:5, nrow(bp), replace = TRUE))以及我们想要使用的颜色的相关向量
cols <- c('red','black','green','navy','purple')并将此颜色矢量展开为长度为nrow(bp)的向量,即每双图分数/变量一种颜色。
cols <- cols[f]接下来开始绘制,准备一个空的绘图区域,我们可以在其中添加箭头。
plot(ord, type = 'n')在上面的例子中,我们离开设置的地块区域,以适应物种和地点/样本的分数。
我们现在计算一个乘法器,它允许双图分数占据绘图区域的指定比例(fill = 0.75)。
mul <- ordiArrowMul(bp, fill = 0.75)最后,添加按组着色的双图箭头。
arrows(0, 0, mul * bp[,1], mul * bp[,2],
       length = 0.05, col = cols)
并将标签添加到双图箭头中。
labs <- rownames(bp)
text(ordiArrowTextXY(mul * bp, labs), labs, col = cols)
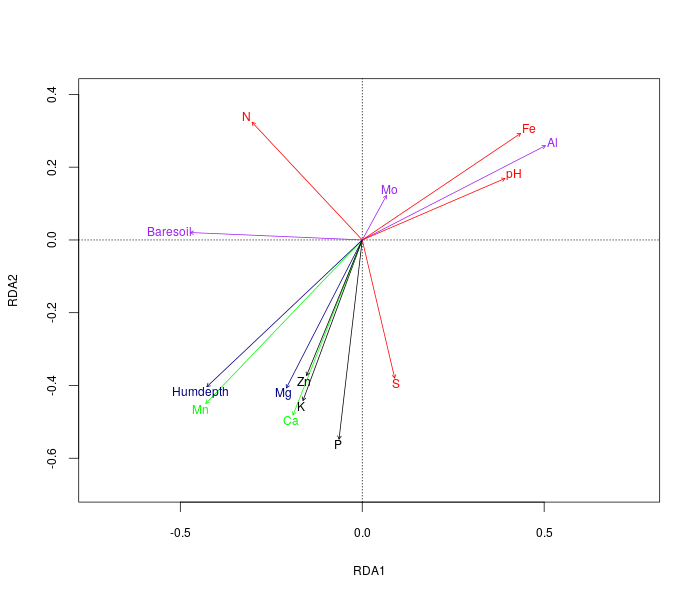
这会产生
https://stackoverflow.com/questions/47658880
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号