
按优先级和组值排序结果,然后过滤结果
以下是我的DynamoDB当前数据:
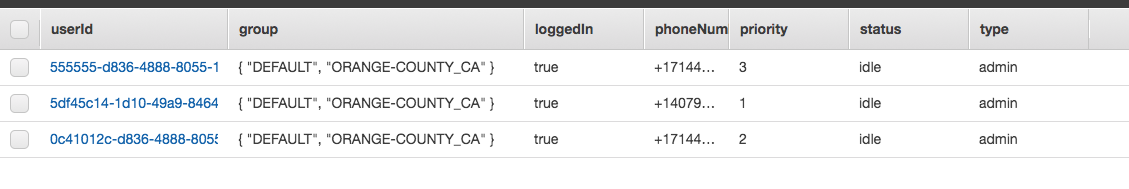
我的目标是创建一个查询,它过滤组集中的结果(如“默认”),然后按优先级排序,然后将结果过滤到那些loggedIn == true和status ==空闲的地方。
在SQL中,它将类似于
SELECT *
FROM userstatustable
WHERE group == "default"
  AND loggedIn == true AND status == "idle"
ORDER BY priority DESC
LIMIT 1
我将如何创建一个查询来完成这个任务?
下面是我对serverless.yml表的DynamoDB文件描述。
userStatusTable: #This table is used to track a users current status.
      Type: AWS::DynamoDB::Table
      Properties:
        TableName: ${self:custom.userStatusTable}
        AttributeDefinitions: #UserID in this case will be created once and constantly updated as it changes with status regarding the user.
          - AttributeName: userId
            AttributeType: S
        KeySchema:
          - AttributeName: userId
            KeyType: HASH
        ProvisionedThroughput:
            ReadCapacityUnits: ${self:custom.dynamoDbCapacityUnits.${self:custom.pstage}}
WriteCapacityUnits: ${self:custom.dynamoDbCapacityUnits.${self:custom.pstage}}我尝试过的事物:
下面是我目前的代码:
 const userStatusParams = {
        TableName: process.env.USERSTATUS_TABLE,
        FilterExpression: "loggedIn = :loggedIn and #s = :status and contains(#g,:group) ",
        //Limit: 1,
        ExpressionAttributeValues: {
          ":loggedIn": true,
          ":status" : "idle",
          ":group" : "DEFAULT"
        },
        ExpressionAttributeNames: {"#s": "status","#g" : "group"}
      };
      var usersResult;
      try {
        usersResult = await dynamoDbLib.call("scan", userStatusParams);
        console.log(usersResult);
      }catch (e) {
        console.log("Error occurred querying for users belong to group.");
        console.log(e);
}它使用扫描并能够返回所有符合标准的结果.但是,不按优先级按降序排序结果。
备注:状态和组显然是保留关键字,所以我不得不使用ExpressionAttributeNames来解释这个问题。还请注意,该表最终将有数千名用户。
回答 3
Stack Overflow用户
发布于 2017-12-02 02:35:21
链接到按设计使用主表的其他答案。
这种方法需要修改group在UserStatus中的建模,从设置字符串的单个记录修改为具有字符串的多个记录。这是因为DynamoDB不支持(虽然这是一个很好的特性请求)键控集。
主表用于更新/插入/删除,如下所示:
+--------+---------+-------+----------+----------+--------+
| userId | group   | type  | priority | loggedIn | status |
+--------+---------+-------+----------+----------+--------+
| 123    | default | admin | 1        | true     | idle   |
+--------+---------+-------+----------+----------+--------+
| 123    | orange  | admin | 1        | true     | idle   |
+--------+---------+-------+----------+----------+--------+
| 124    | default | admin | 3        | false    | idle   |
+--------+---------+-------+----------+----------+--------+
| 125    | orange  | admin | 2        | false    | idle   |
+--------+---------+-------+----------+----------+--------+- 分区/哈希键: userId
- 排序键:组
在(组,优先级)上设置GSI。这将用于查询。是的,为这个索引选择的组合会有重复的: DynamoDB不麻烦这个,而且工作得很好。
+---------+----------+--------+-------+----------+--------+
| group   | priority | userId | type  | loggedIn | status |
+---------+----------+--------+-------+----------+--------+
| default | 1        | 123    | admin | true     | idle   |
+---------+----------+--------+-------+----------+--------+
| default | 3        | 124    | admin | false    | idle   |
+---------+----------+--------+-------+----------+--------+
| orange  | 1        | 123    | admin | true     | idle   |
+---------+----------+--------+-------+----------+--------+
| orange  | 2        | 125    | admin | false    | idle   |
+---------+----------+--------+-------+----------+--------+
任务:
- 更新此表上的用户需要更新/插入用户所属的组的行数;
- 删除用户意味着删除用户的所有项。
- 查询由
group = :group and priority >= :priority完成,在status = 'idle' and loggedIn = true上进行过滤- 变体是对状态或loggedIn进行排序,因为您使用它们进行筛选,这有助于使查询更具选择性,然后对客户端的优先级进行排序。
我应该遵循这个方法吗?我认为这是一个很好的设计,当有许多组,一个组包含20%的总用户,并且用户属于2或2个组。
Stack Overflow用户
发布于 2017-12-01 11:31:17
索引与排序无关。排序只是一种有效地检索行的方法,因为排序数组中的搜索可以在对数时间O(log )中完成,而不是线性时间O(n)。这只是按排序顺序返回行的结果。但是,让我们关注的功能,即用较少的精力查找要返回的确切行, (I/O,例如磁盘读取)。
这种类型的查询(按组、状态和几个列)的过滤需求对于DynamoDB fo进程来说是非常困难的。效率是指DynamoDB需要从磁盘中检索多少行以确定哪些行返回到客户端。如果它返回从表读取的全部行的10%,这是无效的。这就是为什么常规的Scan和filters不如indexed query的原因。过滤器是一个谎言,因为它们仍然从数据库中读取项目,并计算到提供的容量。索引查询将从接近其实际返回的数字的存储行中检索。这是通过DynamoDB实现的,但限制在单个分区(具有相同分区/哈希键的项)和排序键的范围(从>=、<=开始)。
为什么在进行扫描时不按排序键返回行?因为DynamoDB使用项集合中的排序键,所以每个集合都由哈希键确定。例如,当结果集包含两个唯一的散列键时,结果集将包含按排序键排序的两个单独的节,换句话说,行将不按单个方向排序,它们将在结果集中的中间重新启动。内存中的排序将被要求有一个排序集合。
那么,为什么不为所有行创建一个可以具有单个值的列的索引呢?如果我们运行扫描,那么行将按优先级(排序键)返回。但是有一个字段的所有项都包含相同的值,这是一个数据异常。
那么我什么时候应该创建一个索引呢?
- 我想查询的字段可能是空的一些/多行,所以索引将包含比整个表少的项目;
- 我的查询将应用一个范围运算符,它将能够选择较小部分的数据;
考虑到group属性可能是最具选择性的,在全局索引上对该属性进行散列会更快,但这将改变模型,要求将每个组存储在单独的项中,而不是使用字符串集。这在NoSQL世界中不太方便,需要更多的关系模型。
因此,考虑到使用扫描是可以的,但没有单独的索引,一种方法就是在内存中运行扫描和排序。使用Array#sort()方法在node.js中执行此操作。性能特性更接近于使用二级索引的方法,在这种情况下,只有索引才会浪费资源。因为如果对索引的查询/扫描返回与表上的扫描相同的大量信息,则应采用表方法。记住:索引是关于在检索行时具有选择性的。
我如何知道这是否是我的用例的好方法?好吧,这不是一个明确的规则,但是如果您想要检索超过50%的表行(),这是可以的。就成本而言,保持一个单独的指数是不会有回报的。甚至研究另一种设计,因为这不是很有选择性的。现在,如果您想要20%或更少的数据,那么另一种方法将是很好的研究。
Stack Overflow用户
发布于 2017-12-01 06:57:37
所以我找到了一个解决这个问题的有趣方法。
这是我的新密码。
const userStatusParams = {
        TableName: process.env.USERSTATUS_TABLE,
        IndexName:"typePriorityIndex",
        FilterExpression: "loggedIn = :loggedIn and #s = :status and contains(#g,:group) ",
        KeyConditionExpression: "#t = :type and priority >= :priority",
        Limit: 1,
        ExpressionAttributeValues: {
          ":loggedIn": true,
          ":status" : "idle",
          ":group" : "DEFAULT",
          ":priority" : 0,
          ":type" : "admin"
        },
        ExpressionAttributeNames: {"#s": "status","#g" : "group", "#t" : "type"}
      };
      var usersResult;
      try {
        usersResult = await dynamoDbLib.call("query", userStatusParams);
        console.log(usersResult);
      }catch (e) {
        console.log("Error occurred querying for users belong to group.");
        console.log(e);
      }
注意IndexName:"typePriorityIndex“的用法,这里的诀窍是在您的表中查找某些内容或使记录都具有相同的内容,并使其成为哈希键,然后排序键应该是您想要排序的对象,在我的例子中,排序键是优先级。
指数看起来是这样给出了一个想法。

我的无服务器文件看起来像这样来定义它
userStatusTable: #This table is used to track a users current status.
      Type: AWS::DynamoDB::Table
      Properties:
        TableName: ${self:custom.userStatusTable}
        AttributeDefinitions: #UserID in this case will be created once and constantly updated as it changes with status regarding the user.
          - AttributeName: userId
            AttributeType: S
          - AttributeName: priority
            AttributeType: N
          - AttributeName: type
            AttributeType: S
        KeySchema:
          - AttributeName: userId
            KeyType: HASH
        ProvisionedThroughput:
            ReadCapacityUnits: ${self:custom.dynamoDbCapacityUnits.${self:custom.pstage}}
            WriteCapacityUnits: ${self:custom.dynamoDbCapacityUnits.${self:custom.pstage}}
        GlobalSecondaryIndexes:
          - IndexName: typePriorityIndex
            KeySchema:
              - AttributeName: type
                KeyType: HASH
              - AttributeName: priority
                KeyType: RANGE
            Projection:
              ProjectionType: ALL
            ProvisionedThroughput:
              ReadCapacityUnits: ${self:custom.dynamoDbCapacityUnits.${self:custom.pstage}}
WriteCapacityUnits: ${self:custom.dynamoDbCapacityUnits.${self:custom.pstage}}https://stackoverflow.com/questions/47585581
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号