
连接OCR的近邻点(一些提示,例如使用形态学操作)
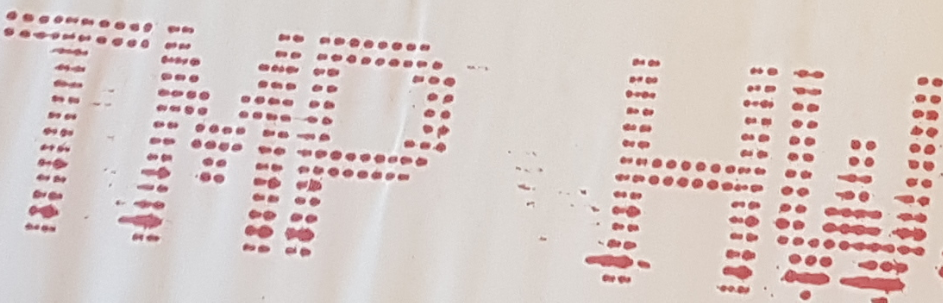
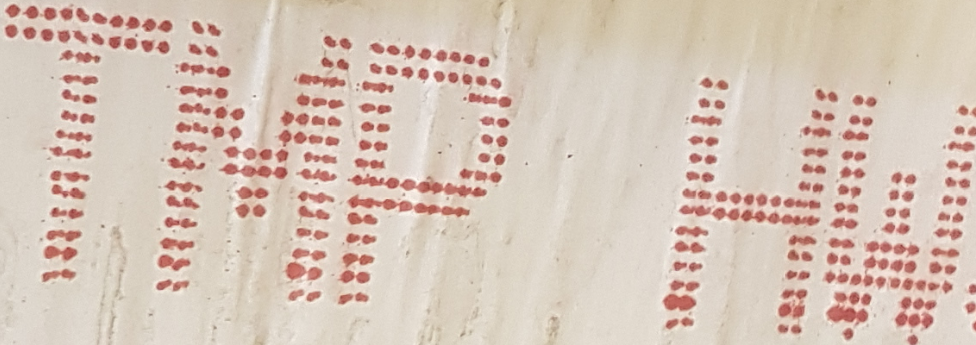
目标:让软件库(如Tesseract )有可能从下面的图片中读到TMP HW的作品。
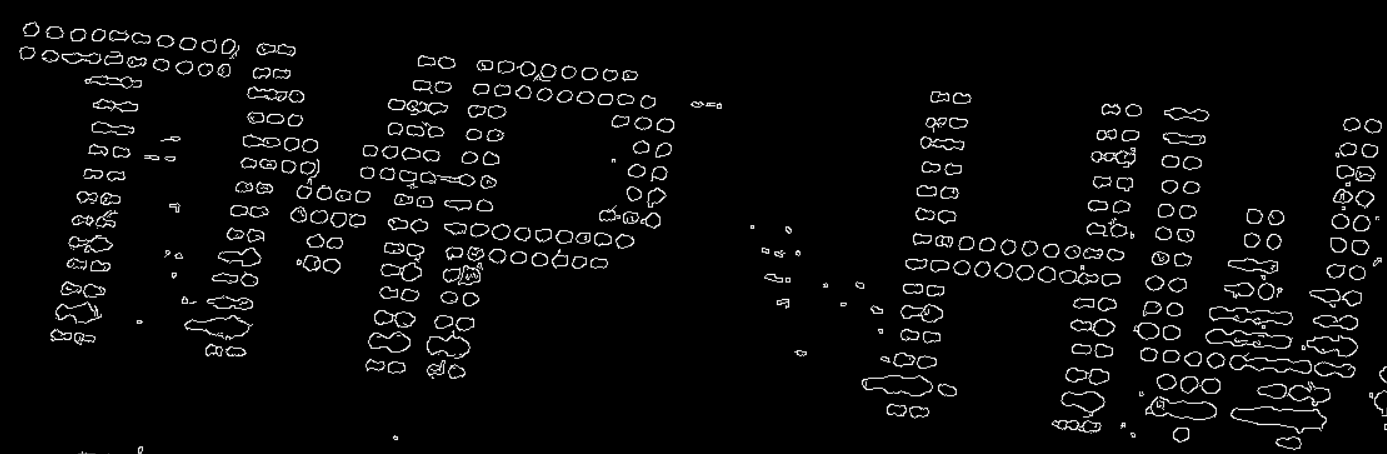
我正在努力寻找方法“连接点”,可以说,使用OpenCV,但我不确定这是可能的。我有像下面这样的不同颜色的虚线文字的图片,然后我把它转换成灰色的图片,然后运用精明的方法来寻找边缘。我尝试过一些模糊、精明、侵蚀和膨胀的东西,但唉,作为一个新手,我似乎找不到办法把这些字母“整”成边缘。
虽然它似乎正在使用OpenCV,但它可以创建相当容易识别的字母,而不是太多的“噪音”(我认为,如果这很重要,也可以找到一种纠正方向的方法),但不知怎么地,在点之间创建边缘以使OCR库更好地工作似乎是不可能的。有小费吗?
例如,作为参考,我找到了How to connect broken lines in a binary image using Python/Opencv和Canny Edge Image - Noise removal。
<编辑:选择的语言,尽管例子等在任何语言可能去。如果有关系的话,我可能会在.NET上工作。
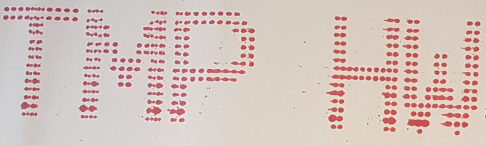
回答 1
Stack Overflow用户
发布于 2017-11-20 14:45:56
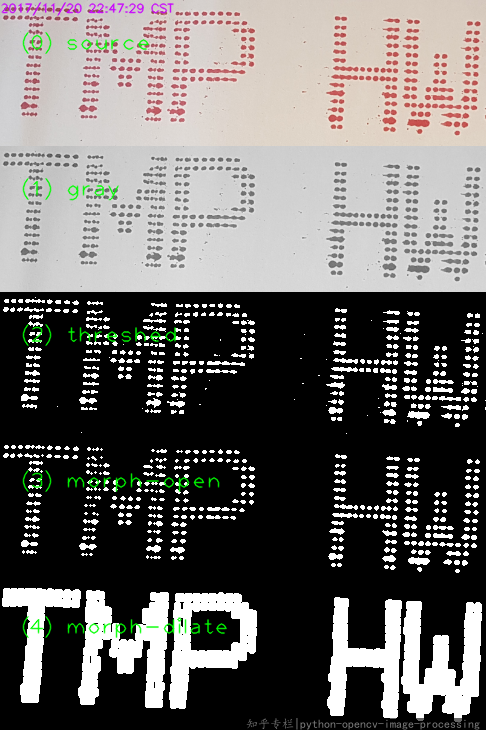
对灰度图像进行阈值化处理,进行morph-open和morph-dilate。
你应该确保空间宽度(高度)在一个合适的范围内。
https://stackoverflow.com/questions/47391811
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号