
文本挖掘R包& Regex用于替换智能卷引号
我有一堆这样的文字,下面有不同的智能引号-单引号和双引号。最后,我所知道的包就是删除这些字符,但是我希望用普通的引号替换它们。
textclean::replace_non_ascii("You don‘t get “your” money’s worth")接收输出:"You dont get your moneys worth"
预期产出:"You don't get "your" money's worth"
如果有人在一次尝试中用正则表达式替换了所有这样的引号,也会很感激。
谢谢!
回答 3
Stack Overflow用户
发布于 2017-11-08 07:26:40
使用两个gsub操作: 1)替换双引号,2)替换单引号:
> gsub("[“”]", "\"", gsub("[‘’]", "'", text))
[1] "You don't get \"your\" money's worth"见在线R演示。在Linux和Windows中都进行了测试,并且工作原理相同。
[“”]构造是一个正的字符类,它与类中定义的任何一个字符匹配。
若要使所有字符标准化(类似于双引号),您可能需要使用
> sngl_quot_rx = "[ʻʼʽ٬‘’‚‛՚︐]"
> dbl_quot_rx = "[«»““”„‟≪≫《》〝〞〟\"″‶]"
> res = gsub(dbl_quot_rx, "\"", gsub(sngl_quot_rx, "'", `Encoding<-`(text, "UTF8")))
> cat(res, sep="\n")
You don't get "your" money's worth在这里,[«»““”„‟≪≫《》〝〞〟"″‶]匹配
«   00AB  LEFT-POINTING DOUBLE ANGLE QUOTATION MARK
»   00BB  RIGHT-POINTING DOUBLE ANGLE QUOTATION MARK
“   05F4  HEBREW PUNCTUATION GERSHAYIM
“   201C  LEFT DOUBLE QUOTATION MARK
”   201D  RIGHT DOUBLE QUOTATION MARK
„   201E  DOUBLE LOW-9 QUOTATION MARK
‟   201F  DOUBLE HIGH-REVERSED-9 QUOTATION MARK
≪  226A  MUCH LESS-THAN
≫  226B  MUCH GREATER-THAN
《  300A  LEFT DOUBLE ANGLE BRACKET
》  300B  RIGHT DOUBLE ANGLE BRACKET
〝  301D  REVERSED DOUBLE PRIME QUOTATION MARK
〞  301E  DOUBLE PRIME QUOTATION MARK
〟  301F  LOW DOUBLE PRIME QUOTATION MARK
"  FF02  FULLWIDTH QUOTATION MARK
″   2033  DOUBLE PRIME
‶ 2036 REVERSED DOUBLE PRIME[ʻʼʽ٬‘’‚‛՚︐]用于规范化一些字符,类似于单引号:
ʻ  02BB  MODIFIER LETTER TURNED COMMA
ʼ  02BC  MODIFIER LETTER APOSTROPHE
ʽ  02BD  MODIFIER LETTER REVERSED COMMA
٬  066C  ARABIC THOUSANDS SEPARATOR
‘  2018  LEFT SINGLE QUOTATION MARK
’  2019  RIGHT SINGLE QUOTATION MARK
‚  201A  SINGLE LOW-9 QUOTATION MARK
‛  201B  SINGLE HIGH-REVERSED-9 QUOTATION MARK
՚   055A  ARMENIAN APOSTROPHE
︐ FE10 PRESENTATION FORM FOR VERTICAL COMMAStack Overflow用户
发布于 2017-11-08 07:52:22
在{proustr}中有一个函数来规范标点符号,称为pr_normalize_punc():
它变成:
 => ″‶«  »“”`´„“ into "
 => ՚ ’ into '
 => … into ...
例如:
library(proustr)
a <- data.frame(text = "Il l՚a dit : « La ponctuation est chelou » !")
pr_normalize_punc(a, text)
# A tibble: 1 x 1
                                            text
*                                          <chr>
1 "Il l'a dit : \"La ponctuation est chelou\" !"
关于你的文字:
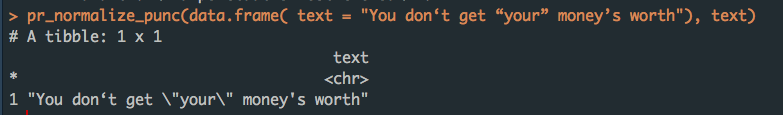
pr_normalize_punc(data.frame( text = "You don‘t get “your” money’s worth"), text)
# A tibble: 1 x 1
                                    text
*                                  <chr>
1 "You don‘t get \"your\" money's worth"
Stack Overflow用户
发布于 2017-11-08 07:12:11
我们可以在这里使用gsub作为基本R选项。一次替换每一个被引用的术语。
text <- "You don‘t get “your” money’s worth"
new_text <- gsub("“(.*?)”", "\"\\1\"", text)
new_text <- gsub("’", "'", new_text)
new_text
[1] "You don‘t get \"your\" money's worth"
我在这里假设,你的卷曲引号总是平衡的,也就是说,它们总是环绕一个词。如果没有,那么你可能需要做更多的工作。
如果你想让它们保持原样,如果你不引用一个词的话,那么对开/收双曲引号做一个全面的替换可能不会像你想要的那样。
https://stackoverflow.com/questions/47173557
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号