
拖尾平均延迟
拖尾平均延迟
提问于 2017-10-31 20:23:30
在使用UNIX traceroute命令时,为了计算每个循环的平均延迟(从一个跳到下一个,例如: hop 8到9),我们应该采取什么步骤?
8   146.97.33.6    2.150 ms  2.159 ms  2.133 ms
9   146.97.33.61   1.580 ms  1.543 ms  1.552 ms
10  146.97.35.170  1.544 ms  1.535 ms  1.526 ms
例如,我知道跳9的平均延迟是1.5583:
1.580 ms+1.543 ms+1.552 ms / 3然而,这是从本地主机到该特定 hop 的平均时间,还是数据包从上一次跳到特定跃点所需的时间?
回答 3
Stack Overflow用户
发布于 2017-10-31 20:30:02
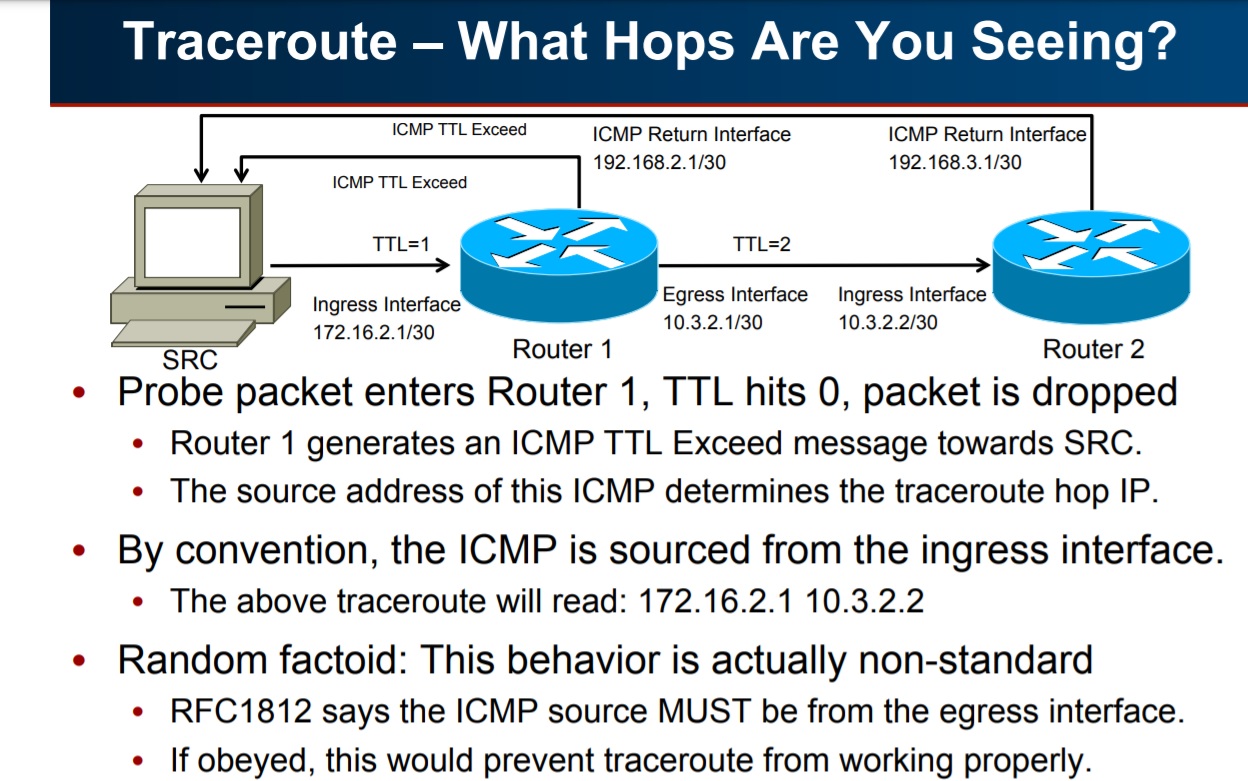
延迟是从原始主机到跳的往返延迟,其中超时并返回到原始主机,但它包括超时跳用于生成返回原始主机的ICMP消息所需的时间。
路由器的主要目的是尽可能快地路由数据包。生成ICMP消息对于路由器来说是一个低得多的优先级。如果路由器忙于路由数据包,则当它有一些空闲时间时,它将有时间生成ICMP消息。
这就是为什么你可以看到一些中间跳的时间要比完整的路径长得多。
Stack Overflow用户
发布于 2017-10-31 20:30:14
根据维基百科的说法,似乎是前者
路由记录为从路由(路径)中的每个连续主机(远程节点)接收的分组的往返时间;每个跳中的平均时间之和是建立连接所花费的总时间的度量。
Stack Overflow用户
发布于 2021-09-07 13:57:56
答案是“从当地的主人到那个特定的跳”
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/47043946
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号