
如何通过DataFrame将一组多列转换为一组标记值,同时又不希望将所有列枢轴
如何通过DataFrame将一组多列转换为一组标记值,同时又不希望将所有列枢轴
提问于 2017-10-26 14:29:56
所以,我有一个先进的枢轴问题。考虑以下数据框架
dfa = pandas.DataFrame([["g1","15","Annie","Bard"], ["g2","18","Lux","Annie"], ["g3","15","Olaf","Twitch"]], columns=["gameId", "duration", "Champ1", "Champ2"])这给出了输出:
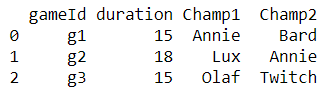
通过在下面的堆栈溢出问题( how to pivot complex dataframe )中应用逻辑,我得到
pandas.melt(dfa, id_vars=['gameId']) \
    .set_index('gameId')['value'] \
    .str.get_dummies() \
    .groupby(level=0) \
    .agg(np.sum)
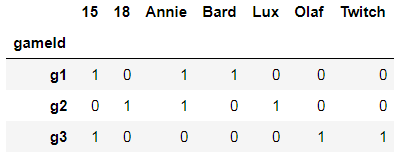
但是,我不想转向工期列,所以我更改代码并添加'value_vars‘
pandas.melt(dfa, id_vars=['gameId'], value_vars = ['Champ1','Champ2']) \
    .set_index('gameId')['value'] \
    .str.get_dummies() \
    .groupby(level=0) \
    .agg(np.sum)
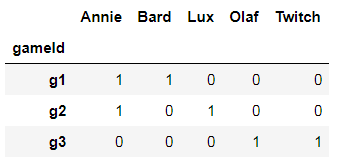
现在我失去了持续时间列。这列不是索引,因为它不是唯一的,但我不想对它进行透视。我尝试过“id_vars”或“set_index()”中添加的所有组合,但它似乎不起作用。
有什么想法?
提前感谢!
回答 1
Stack Overflow用户
回答已采纳
发布于 2017-10-26 14:33:29
您可以将列duration添加到id_vars,然后按Multiindex中的两个级别添加到set_index和最后一个groupby,如下所示:
a = pd.melt(dfa, id_vars=['gameId', 'duration']) \
    .set_index(['gameId', 'duration'])['value'] \
    .str.get_dummies()
    .sum(level=[0,1])
print (a)
                 Annie  Bard  Lux  Olaf  Twitch
gameId duration
g1     15            1     1    0     0       0
g2     18            1     0    1     0       0
g3     15            0     0    0     1       1
与以下内容相同:
a = pd.melt(dfa, id_vars=['gameId', 'duration']) \
    .set_index(['gameId', 'duration'])['value'] \
    .str.get_dummies() \
    .groupby(level=[0,1]) \
    .sum()
print (a)
                 Annie  Bard  Lux  Olaf  Twitch
gameId duration
g1     15            1     1    0     0       0
g2     18            1     0    1     0       0
g3 15 0 0 0 1 1页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/46957041
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号