
Pandas -融化,枢轴,在多个柱上转置
Pandas -融化,枢轴,在多个柱上转置
提问于 2017-09-18 19:57:35
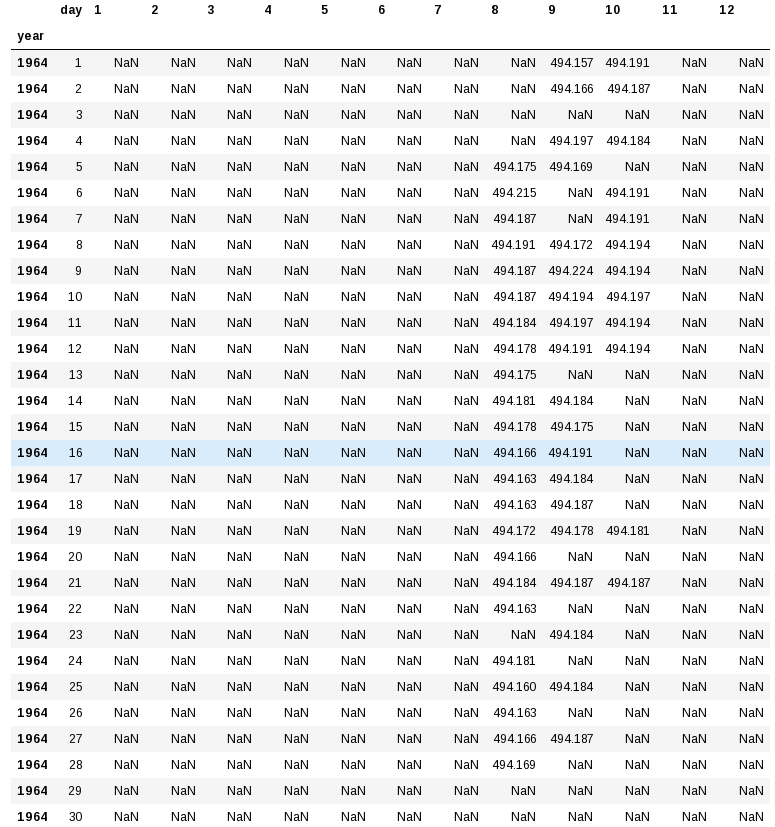
我有一个数据文件,如下所示。索引为年份(1964至2016年,非唯一,每年重复31次),第1栏为天数(1至31),第2至13栏为月份(1至12)。
问题是:如何将其转换为带有pd.DatetimeIndex日期的Pandas系列(或单列df)?我尝试过使用groupby、熔体、枢轴和转置,但是我无法找到正确的语法,文档也不清楚。非常感谢你的帮助!
回答 1
Stack Overflow用户
回答已采纳
发布于 2017-09-18 20:07:33
我们希望利用pd.to_datetime功能,它使用具有相关名称的列的数据格式。在本例中,'year'、'month'和'day'。
因此,下面的解决方案将针对这三列创建这样一个数据格式,并将其传递给pd.to_datetime。
- 我们在索引中已经有
'year'了..。所以让我们把索引中的所有内容都找出来。让我们从使用'day'在索引中获取df.set_index('day', append=True)开始 - 接下来,我们将把
'month'引入索引。但现在它就在专栏里。首先,我们用.rename_axis('month', 1)重命名列 - 然后,我们使用
.stack()将其放入索引中。 - 现在我有3列索引值。当我使用
reset_index时,我将把3列推到dataframe前面。因此,我将reset_index并使用.reset_index().iloc[:, :3]的前三列并将其传递给pd.to_datetime - 由于某些组合可能不存在,比如
'1964-02-31',我们传递errors='coerce',它将为这样的日期返回NaT。 - 最后,我们使用
loc和从索引中删除空值来过滤结果。
样本数据
df = pd.DataFrame({
    'day': [1, 2, 3], 1: [8, 5, 3]
}, pd.Index([1999, 1999, 1999], name='year'))

df

      day  1
year
1999    1  8
1999    2  5
1999    3  3
溶液
s = df.set_index('day', append=True).rename_axis('month', 1).stack()
s.index = pd.to_datetime(s.reset_index().iloc[:, :3], errors='coerce')
s = s.loc[s.index.dropna()]

s

1999-01-01    8
1999-01-02    5
1999-01-03    3
dtype: int64
全数据
df = pd.DataFrame(
    np.arange(31 * 12).reshape(31, 12),
    pd.Index([1964 for _ in range(31)], name='year'),
    np.arange(12) + 1
).assign(day=np.arange(31) + 1).iloc[:, [-1] + np.arange(12).tolist()]

df

      day    1    2    3    4    5    6    7    8    9   10   11   12
year
1964    1    0    1    2    3    4    5    6    7    8    9   10   11
1964    2   12   13   14   15   16   17   18   19   20   21   22   23
1964    3   24   25   26   27   28   29   30   31   32   33   34   35
1964    4   36   37   38   39   40   41   42   43   44   45   46   47
1964    5   48   49   50   51   52   53   54   55   56   57   58   59
1964    6   60   61   62   63   64   65   66   67   68   69   70   71
1964    7   72   73   74   75   76   77   78   79   80   81   82   83
1964    8   84   85   86   87   88   89   90   91   92   93   94   95
1964    9   96   97   98   99  100  101  102  103  104  105  106  107
1964   10  108  109  110  111  112  113  114  115  116  117  118  119
1964   11  120  121  122  123  124  125  126  127  128  129  130  131
1964   12  132  133  134  135  136  137  138  139  140  141  142  143
1964   13  144  145  146  147  148  149  150  151  152  153  154  155
1964   14  156  157  158  159  160  161  162  163  164  165  166  167
1964   15  168  169  170  171  172  173  174  175  176  177  178  179
1964   16  180  181  182  183  184  185  186  187  188  189  190  191
1964   17  192  193  194  195  196  197  198  199  200  201  202  203
1964   18  204  205  206  207  208  209  210  211  212  213  214  215
1964   19  216  217  218  219  220  221  222  223  224  225  226  227
1964   20  228  229  230  231  232  233  234  235  236  237  238  239
1964   21  240  241  242  243  244  245  246  247  248  249  250  251
1964   22  252  253  254  255  256  257  258  259  260  261  262  263
1964   23  264  265  266  267  268  269  270  271  272  273  274  275
1964   24  276  277  278  279  280  281  282  283  284  285  286  287
1964   25  288  289  290  291  292  293  294  295  296  297  298  299
1964   26  300  301  302  303  304  305  306  307  308  309  310  311
1964   27  312  313  314  315  316  317  318  319  320  321  322  323
1964   28  324  325  326  327  328  329  330  331  332  333  334  335
1964   29  336  337  338  339  340  341  342  343  344  345  346  347
1964   30  348  349  350  351  352  353  354  355  356  357  358  359
1964 31 360 361 362 363 364 365 366 367 368 369 370 371s = df.set_index('day', append=True).rename_axis('month', 1).stack()
s.index = pd.to_datetime(s.reset_index().iloc[:, :3], errors='coerce')
s = s.loc[s.index.dropna()]
s
1964-01-01 0
1964-02-01 1
1964-03-01 2
1964-04-01 3
1964-05-01 4
1964-06-01 5
1964-07-01 6
1964-08-01 7
1964-09-01 8
1964-10-01 9
1964-11-01 10
1964-12-01 11
1964-01-02 12
1964-02-02 13
1964-03-02 14
...
1964-05-30 352
1964-06-30 353
1964-07-30 354
1964-08-30 355
1964-09-30 356
1964-10-30 357
1964-11-30 358
1964-12-30 359
1964-01-31 360
1964-03-31 362
1964-05-31 364
1964-07-31 366
1964-08-31 367
1964-10-31 369
1964-12-31 371
Length: 366, dtype: int64替代
lol = [[y, m, d] for y, d in zip(df.index, df.day) for m in df.columns[1:]]
columns = ['year', 'month', 'day']
d1 = pd.DataFrame(lol, columns=columns)
dates = pd.to_datetime(d1, errors='coerce')
m = dates.notnull().values

pd.Series(df.drop('day', 1).values.ravel()[m], dates[m])页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/46287241
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号