
检查PDF是否可搜索
我编写了一个bash脚本,从扫描的PDF文件中提取纯文本。我有很多PDF文件,但有些是扫描的,另一些则没有。所以现在我的主要目标是通过检查PDF是否已经可以搜索来改进我的脚本,所以不需要提取OCR。
我试过:
pdftext -nopgbrk pdf_file.pdf wordlist
要在wordlist中存储可能的OCR‘’ed文本,那么我可以检查它是否为空,并确定它是否为可搜索的PDF。
我还尝试过pdffonts pdf_file.pdf检查该PDF中是否有字体,因此是否有文本在上面。
这两种方法都很好,但在某些情况下却失败了。
例如,一些PDF我需要OCR是数字签名,而这些签名总是添加一个文本层到PDF。因此,当我运行这两个命令中的任何一个时,它将输出签名的文本或它使用的字体。就像它仅仅因为签名就找到了纯文本一样。它可能只是一个带有数字签名的扫描PDF,但它将被检测为纯文本PDF。
数字签名总是以这种方式添加文本(使用Helvetica字体):
签名:姓名
日期: CEST日期
公司名称:公司名称
因此,在以下方面:
pdftext -nopgbrk pdf_file.pdf wordlist | grep -v -E 'Signed|Date|Company'
我可以设法删除这些行,所以如果它真的是一个扫描PDF,输出将是空的。
它适用于一些PDF,直到我注意到有其他格式的签名,所以我觉得这是一个工作,而不是一个很好的解决方案。
是否有任何方法来检查PDF是否完全可搜索?我只是需要一种方法来提取PDF的文本,但省略数字签名。此外,grep -v将始终取决于我们的数字签名的格式,如果它改变,那么它会搞砸我的脚本。
谢谢。
回答 1
Stack Overflow用户
发布于 2017-07-26 17:10:02
不幸的是,如果不对文件进行更多的分析,而这将远远超出bash脚本的范围和规模,那么以“非黑客”的方式来完成这一任务并不是一件容易的事情。
当pdftotext输出用于数字签名的文本时,该文本并不来自数字签名本身。它作为一个对象存储在PDF中,其中包含pdftotext忽略的元数据。相反,pdftotext得到的只是:也添加到文件中的文本。
下面是来自Adobe的示例签名PDF文档的一个例子。首先,数字签名的元数据:
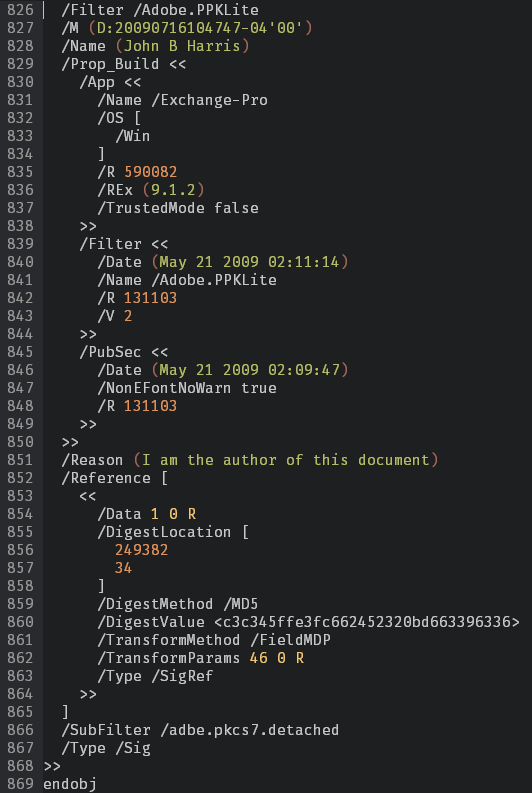
这是插入到文件中的案文:
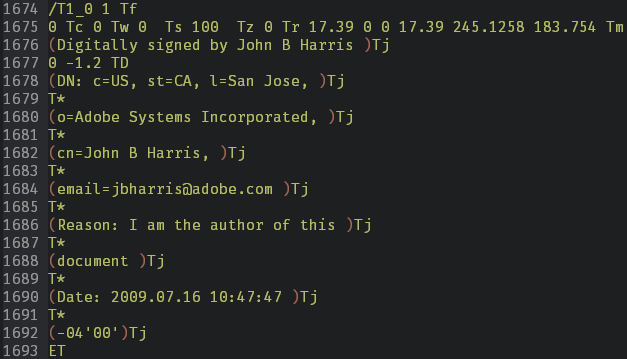
从技术上讲,您可以拥有一个没有另一个,并且没有既定格式的文本通常伴随着数字签名。因此,你要么被困在:
- 使用
grep忽略特定的文本,就像您现在所做的那样,这可能是不可靠的。 - 在所有文件上运行OCR,然后检查OCR前后的文本是否有差异,但这首先违背了检查的全部目的。
https://stackoverflow.com/questions/45326112
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号