
如何使用“equals()”比较Java中的汉字
我想比较一个字符串部分(即字符)和一个汉字。我想,由于Unicode编码,它可以算作两个字符,所以我在字符串中循环,增量为2。现在我遇到了一个路障,在那里我试图检测'兒‘字符,但是兒与它不匹配,那么我遗漏了什么呢?这是代码片段:
for (int CharIndex = 0; CharIndex < tmpChar.length(); CharIndex=CharIndex+2) {

   // Account for 'r' like in dianr/huir
   if (tmpChar.substring(CharIndex,CharIndex+2).equals("兒")) {
还有,你可以建议一种更优雅的方法来解析这个.
从调试器中更新了的一些图片,显示它不匹配,尽管它应该匹配。我从用作输入的电子表格中粘贴汉字,所以我不认为这是复制和粘贴问题(除非unicode在途中丢失)
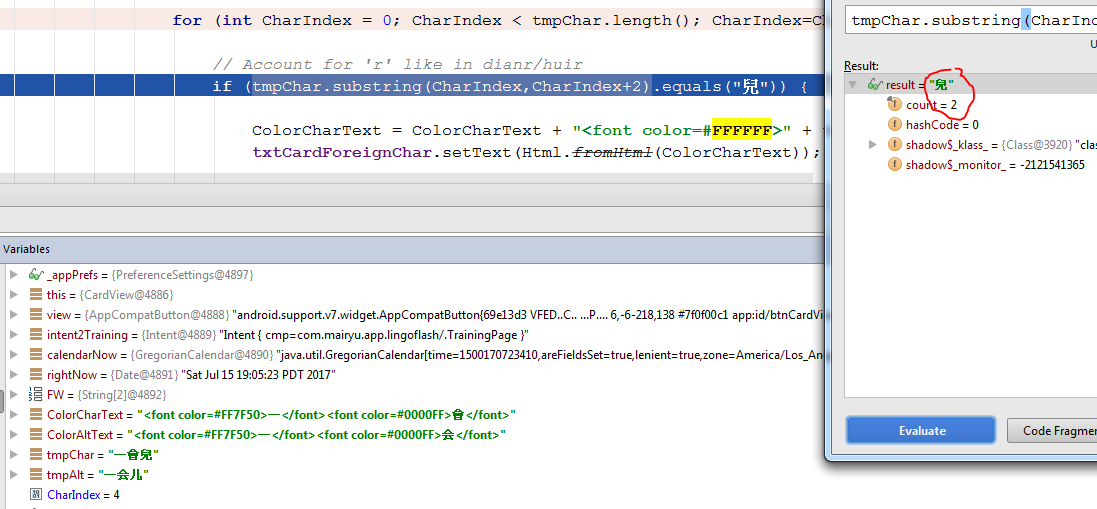
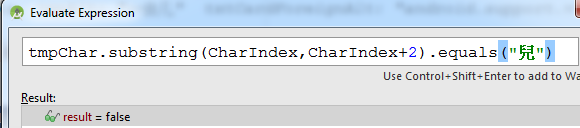
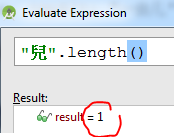
哦,天哪,显然它不是简单的复制和粘贴:
回答 3
Stack Overflow用户
发布于 2017-07-16 00:18:19
使用CharSequence.codePoints(),它返回代码点的流,而不必处理字符:
tmpChar.codePoints().forEach(c -> {
  if (c == '兒') {
    // ...
  }
});(当然,你可以使用tmpChar.codePoints().filter(c -> c == '兒').forEach(c -> { /* ... */ }))。
Stack Overflow用户
发布于 2017-07-16 00:33:04
任一个字符,接受兒作为子字符串。
String s = ...;
if (s.contains("兒")) { ... }
int position = s.indexOf("兒");
if (position != -1) {
    int position2 = position + "兒".length();
    s = s.substring(0, position) + "*" + s.substring(position2);
}
if (s.startsWith("兒", i)) {
    // At position i there is a 兒.
}
或者是一个代码点的代码点。因为这并不是很容易,所以变量子字符串看起来很好。
Stack Overflow用户
发布于 2017-07-17 03:49:28
if (tmpChar.substring(CharIndex,CharIndex+2).equals("兒")) {是你的问题。兒只是一个UTF-16字符.许多汉字可以在一个代码单元中用UTF-16表示,Java使用UTF-16.但是,其他字符是两个代码单元。
在String类中有各种各样的API可供处理。
正如在另一个答案中所提供的那样,从IntStream获得codepoints允许您为每个字符获得一个32位的代码点。您可以将其与要查找的字符的代码点值进行比较。
或者,可以使用ICU4J库为所有这些提供更丰富的工具集。
https://stackoverflow.com/questions/45123798
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号