
在执行jdbc保存时给予空指针异常
在执行jdbc保存时给予空指针异常
提问于 2017-07-13 18:04:35
嗨,当我执行以下代码行时,我将得到以下堆栈跟踪:
transactionDF.write.format("jdbc")
        .option("url",SqlServerUri)
        .option("driver", driver)
        .option("dbtable", fullQualifiedName)
        .option("user", SqlServerUser).option("password",SqlServerPassword)
        .mode(SaveMode.Append).save()
以下是堆栈跟踪:
at org.apache.spark.sql.catalyst.expressions.GeneratedClass$SpecificUnsafeProjection.apply_3$(Unknown Source)
at org.apache.spark.sql.catalyst.expressions.GeneratedClass$SpecificUnsafeProjection.apply(Unknown Source)
at org.apache.spark.sql.execution.LocalTableScanExec$$anonfun$1.apply(LocalTableScanExec.scala:41)
at org.apache.spark.sql.execution.LocalTableScanExec$$anonfun$1.apply(LocalTableScanExec.scala:41)
at scala.collection.TraversableLike$$anonfun$map$1.apply(TraversableLike.scala:234)
at scala.collection.TraversableLike$$anonfun$map$1.apply(TraversableLike.scala:234)
at scala.collection.mutable.ResizableArray$class.foreach(ResizableArray.scala:59)
at scala.collection.mutable.ArrayBuffer.foreach(ArrayBuffer.scala:48)
at scala.collection.TraversableLike$class.map(TraversableLike.scala:234)
at scala.collection.AbstractTraversable.map(Traversable.scala:104)
at org.apache.spark.sql.execution.LocalTableScanExec.<init>(LocalTableScanExec.scala:41)
at org.apache.spark.sql.execution.SparkStrategies$BasicOperators$.apply(SparkStrategies.scala:394)
at org.apache.spark.sql.catalyst.planning.QueryPlanner$$anonfun$1.apply(QueryPlanner.scala:62)
at org.apache.spark.sql.catalyst.planning.QueryPlanner$$anonfun$1.apply(QueryPlanner.scala:62)
at scala.collection.Iterator$$anon$12.nextCur(Iterator.scala:434)
at scala.collection.Iterator$$anon$12.hasNext(Iterator.scala:440)
at scala.collection.Iterator$$anon$12.hasNext(Iterator.scala:439)
at org.apache.spark.sql.catalyst.planning.QueryPlanner.plan(QueryPlanner.scala:92)
at org.apache.spark.sql.catalyst.planning.QueryPlanner$$anonfun$2$$anonfun$apply$2.apply(QueryPlanner.scala:77)
at org.apache.spark.sql.catalyst.planning.QueryPlanner$$anonfun$2$$anonfun$apply$2.apply(QueryPlanner.scala:74)
at scala.collection.TraversableOnce$$anonfun$foldLeft$1.apply(TraversableOnce.scala:157)
at scala.collection.TraversableOnce$$anonfun$foldLeft$1.apply(TraversableOnce.scala:157)
at scala.collection.Iterator$class.foreach(Iterator.scala:893)
at scala.collection.AbstractIterator.foreach(Iterator.scala:1336)
at scala.collection.TraversableOnce$class.foldLeft(TraversableOnce.scala:157)
at scala.collection.AbstractIterator.foldLeft(Iterator.scala:1336)
at org.apache.spark.sql.catalyst.planning.QueryPlanner$$anonfun$2.apply(QueryPlanner.scala:74)
at org.apache.spark.sql.catalyst.planning.QueryPlanner$$anonfun$2.apply(QueryPlanner.scala:66)
at scala.collection.Iterator$$anon$12.nextCur(Iterator.scala:434)
at scala.collection.Iterator$$anon$12.hasNext(Iterator.scala:440)
at org.apache.spark.sql.catalyst.planning.QueryPlanner.plan(QueryPlanner.scala:92)
at org.apache.spark.sql.execution.QueryExecution.sparkPlan$lzycompute(QueryExecution.scala:84)
at org.apache.spark.sql.execution.QueryExecution.sparkPlan(QueryExecution.scala:80)
at org.apache.spark.sql.execution.QueryExecution.executedPlan$lzycompute(QueryExecution.scala:89)
at org.apache.spark.sql.execution.QueryExecution.executedPlan(QueryExecution.scala:89)
at org.apache.spark.sql.execution.QueryExecution$$anonfun$toString$3.apply(QueryExecution.scala:237)
at org.apache.spark.sql.execution.QueryExecution$$anonfun$toString$3.apply(QueryExecution.scala:237)
at org.apache.spark.sql.execution.QueryExecution.stringOrError(QueryExecution.scala:112)
at org.apache.spark.sql.execution.QueryExecution.toString(QueryExecution.scala:237)
at org.apache.spark.sql.execution.SQLExecution$.withNewExecutionId(SQLExecution.scala:54)
at org.apache.spark.sql.Dataset.withNewExecutionId(Dataset.scala:2788)
at org.apache.spark.sql.Dataset.foreachPartition(Dataset.scala:2319)
at org.apache.spark.sql.execution.datasources.jdbc.JdbcUtils$.saveTable(JdbcUtils.scala:670)
at org.apache.spark.sql.execution.datasources.jdbc.JdbcRelationProvider.createRelation(JdbcRelationProvider.scala:77)
at org.apache.spark.sql.execution.datasources.DataSource.write(DataSource.scala:518)
at org.apache.spark.sql.DataFrameWriter.save(DataFrameWriter.scala:215)
at com.test.spark.jobs.ingestion.test$.main(test.scala:193)
at com.test.spark.jobs.ingestion.test.main(test.scala)
at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62)
at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
at java.lang.reflect.Method.invoke(Method.java:498)
at org.apache.spark.deploy.SparkSubmit$.org$apache$spark$deploy$SparkSubmit$$runMain(SparkSubmit.scala:743)
at org.apache.spark.deploy.SparkSubmit$.doRunMain$1(SparkSubmit.scala:187)
at org.apache.spark.deploy.SparkSubmit$.submit(SparkSubmit.scala:212)
at org.apache.spark.deploy.SparkSubmit$.main(SparkSubmit.scala:126)
at org.apache.spark.deploy.SparkSubmit.main(SparkSubmit.scala)
我试过调试它,并且我相信查询执行会导致空指针异常。
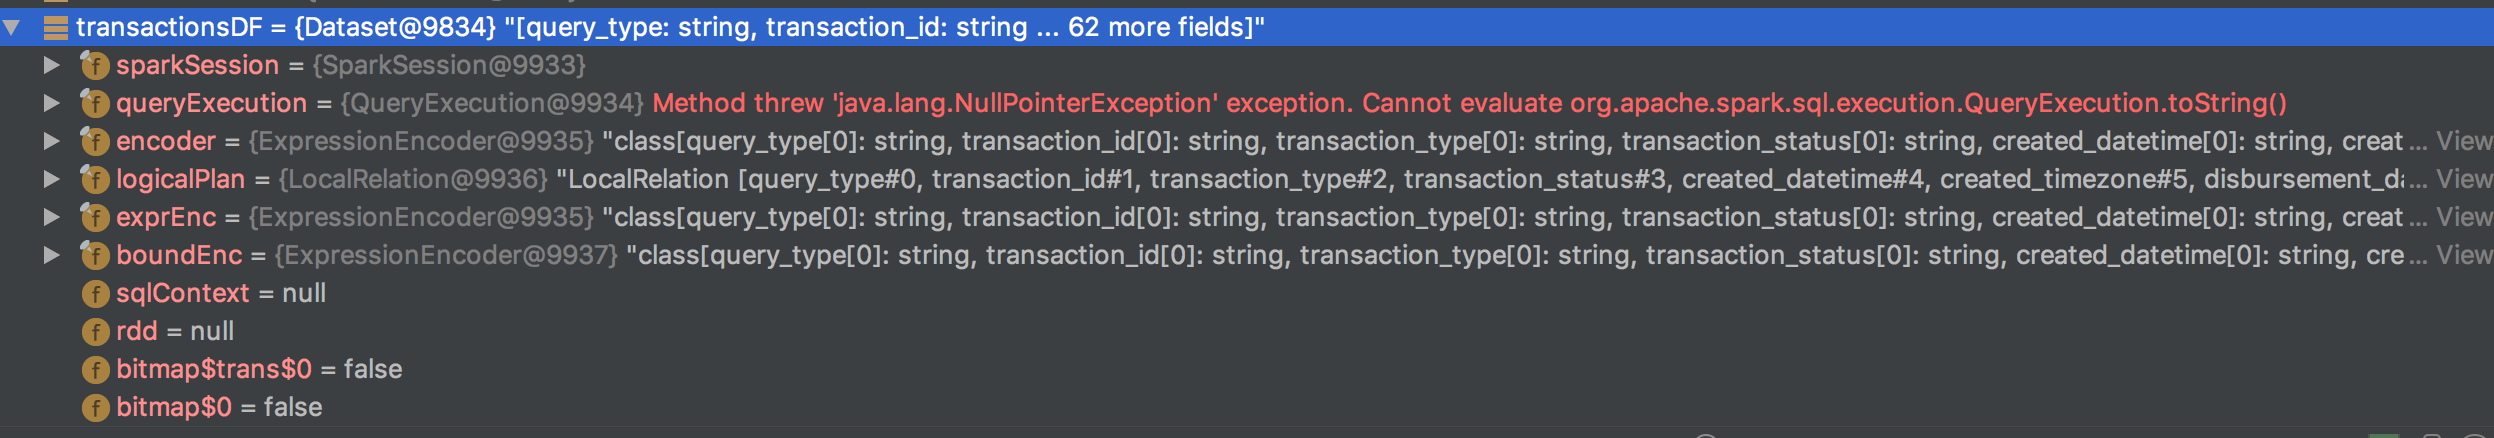
我不知道这是什么意思。我正在本地机器上运行这个程序,而不是在任何集群上运行。
任何帮助都将不胜感激。
回答 1
Stack Overflow用户
回答已采纳
发布于 2017-07-18 15:00:32
我想出来了(Alteast,我认为这就是原因)。对于面临类似情况的其他人:在创建表时,我将每一列设置为null,因此我假设它允许在表中插入空值。但是,我正在构建的Avro模式-- dataframe有nullable = false。因此,dataframe.create读取null,从而引发NPE错误。当我执行Dataframe.write时会引发错误(这使我认为这是jdbc错误),但是实际的NPE是在创建dataframe时发生的。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/45088036
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号