
WEKA中的加速度计缺失数据及分类
WEKA中的加速度计缺失数据及分类
提问于 2017-06-14 03:27:41
为了活动识别的目的,我收集了加速度计和陀螺仪数据在步行活动中,从两个不同的设备。我有两个设备的加速度计数据(x,y,z)和陀螺仪数据(x,y和z),我正在尝试构建我的特征向量。下面是我的特征向量的一个例子(请注意,我对每个坐标都有数百个读数: x、y和z):
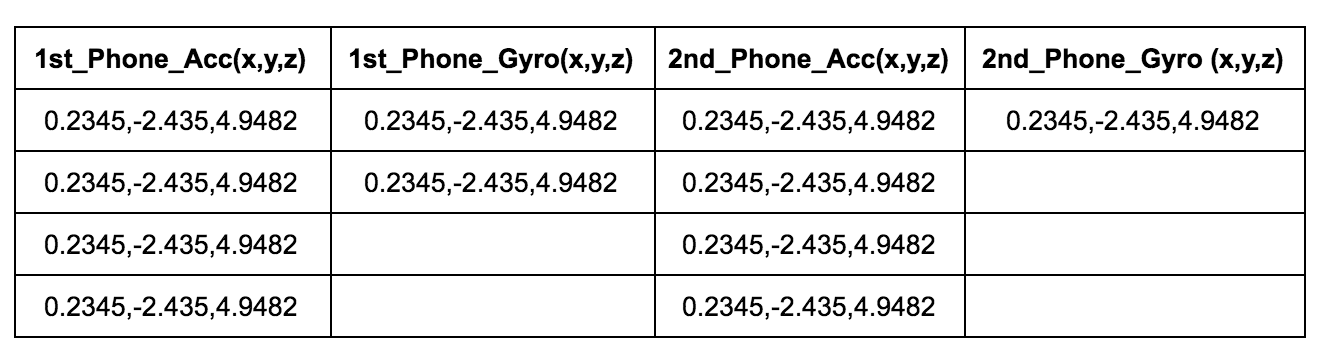
我的问题:
- 在某些情况下,我有较少的阅读样本,例如在1st_phone_Gyro和2nd_Phone_Gyro中,我该如何处理这里的空白呢?如果我有这些空的单元格,我是否应该设置零,知道WEKA在抱怨。有零会影响分类吗?
- 有什么建议可以提取哪些特征来提高性能,什么样的算法才能给出最佳的识别结果?
回答 1
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/44534894
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号