
SUM()在SQL中花费的时间少于SELECT()。它是如何工作的?
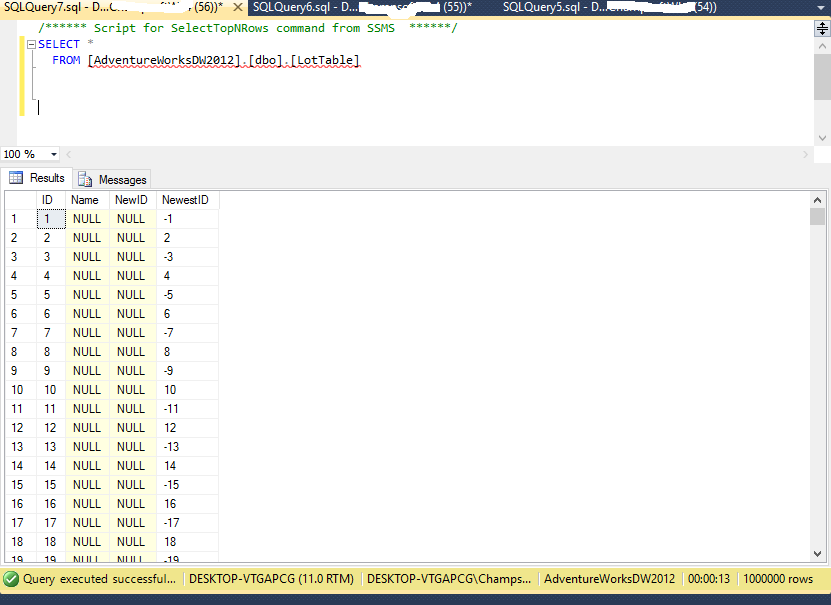
我有一个包含100万条记录的SQL表。当我打电话的时候
SELECT *
   FROM [AdventureWorksDW2012].[dbo].[LotTable]
完成查询花费了13秒时间。
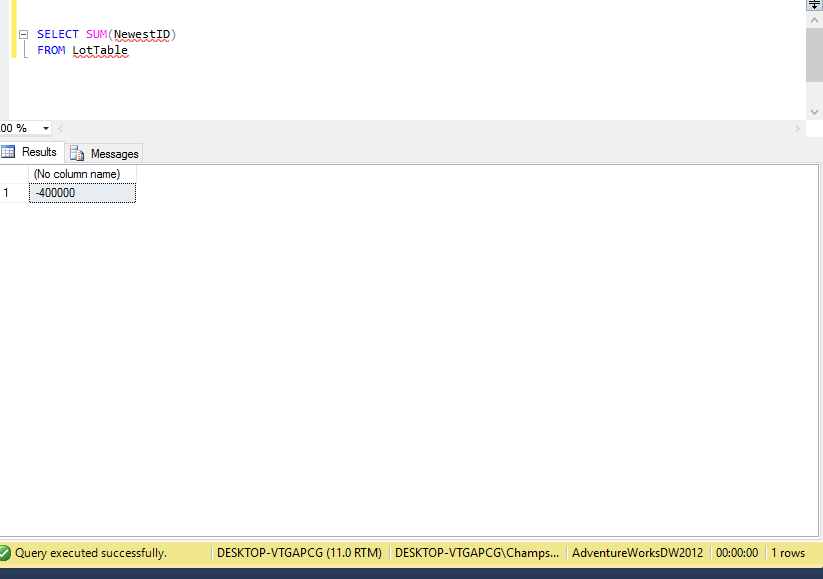
我运行下面的查询来获取ID列的SUM()。它包含包含正负值的随机数。
 SELECT SUM(NewestID)
   FROM LotTable
这个查询只花了500毫秒。要执行SUM(),SQL引擎应该读取值并对其应用一些操作。但是它的运行速度比SELECT()更快。背后的逻辑是什么?请提前参考下面的images.Thanks。
回答 3
Stack Overflow用户
发布于 2017-05-17 09:45:13
这就是人们所期望的行为。您可以看到,当您向数据库系统发送查询时,会发生以下几种情况:
- 对查询进行分析、优化和设计执行模式,
- 查询被执行(!),
- 结果将传递给客户端(!)
最后两个项目(带有感叹号)是加速的潜在来源。
首先,如果您总结值,您不需要存储所有这些值。实际上,您使用的是累加器。因此,成熟的数据库系统将使用值0初始化累加器,然后对于它找到的每一行(匹配可选约束),它将将该值添加到累加器中。关键是,累加器使用固定数量的内存。例如,对于一个整数,它通常小于10个字节。因此,累加器存储在(快速)内存中。
SUM(..)的一个优点是它是结合的:((a+b)+c)+d等于(a+b)+(c+d)。因此,根据数据库的工作方式和配置方式,它可以在几个工作人员之间分配任务,每个工作人员计算表的一个部分的总和。然后将这些子和相加在一起。
另一方面,如果执行SELECT查询,则结果将逐行写入。因此,存在线性内存使用:对于匹配的每一行,我们都需要内存。对于大型表,旧行可能被“交换”出CPU缓存,有时甚至是内存。因此,执行查询需要更长的时间。
最后,系统需要响应。现在,如果您执行一个SUM(..),那就是一行。所以传输的数据量很小。SELECT查询通常会传输数百行。当然,传输大量的数据比传输少量的数据花费更多的时间。
Stack Overflow用户
发布于 2017-05-17 09:43:48
的简短回答(从DBA的角度来看):
这是因为SELECT *必须返回比SELECT SUM(NewestID)更多的列和行。
而且,SUM()可能并行运行,这就是为什么它可能运行得更快的原因。
Alsooo,SSMS中的结果集显示非常慢,为了比较查询的实际执行时间,您可以在会话开始时使用SET STATISTICS TIME ON。所以,
SET STATISTICS TIME ON

SELECT *
FROM [AdventureWorksDW2012].[dbo].[LotTable]

SELECT SUM(NewestID)
FROM [AdventureWorksDW2012].[dbo].[LotTable]现在移到Messages选项卡,查看查询的执行时间:
- CPU时间:在CPU上进行的操作,如聚合(
SUM、AVG等)或其他算术操作。 - 运行时间: CPU时间+存储在RAM中所需的时间,通过内存总线、网络等发送结果。
您可以尝试的另一件事是放弃在SSMS中显示结果。转到Tools -> Options,->查询结果,-> Server ->结果,并检查“执行后丢弃的结果”。
打开一个新选项卡,再次运行您的查询,并查看它们的执行时间比较。(确保取消选中该选项,以便在新会话的其他选项卡中返回结果)。
实际上,可能有更多的因素,比如NewestID列上有索引,或者表上有(或没有)聚集索引。
Stack Overflow用户
发布于 2017-05-17 09:45:34
因为您只使用了一个带函数的字段
https://stackoverflow.com/questions/44021032
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号