
熊猫数据:将索引改为年份,列改为月份
熊猫数据:将索引改为年份,列改为月份
提问于 2017-04-12 19:19:07
目前,我正在处理弗雷德的一些数据,这些数据是我使用quandl提取的。我收到的数据是在一个数据文件中。
它目前的返回方式如下
DATE    VALUE
1966-01-01  31.880
1966-02-01  32.080
1966-03-01  32.180
1966-04-01  32.280
... ...
2013-08-01  233.323
2013-09-01  233.632
2013-10-01  233.718
2013-11-01  234.121
但我想重新整理一下,以下列方式展示:
        Jan     Feb     Mar     Apr...
1966    31.880  32.080  32.180  32.280
...
2013    233.323 233.632 233.718 234.121
编辑:我认为这是有用的。
DatetimeIndex(['1966-01-01', '1966-02-01', '1966-03-01', '1966-04-01',
               '1966-05-01', '1966-06-01', '1966-07-01', '1966-08-01',
               '1966-09-01', '1966-10-01',
               ...
               '2015-04-01', '2015-05-01', '2015-06-01', '2015-07-01',
               '2015-08-01', '2015-09-01', '2015-10-01', '2015-11-01',
               '2015-12-01', '2016-01-01'],
              dtype='datetime64[ns]', name=u'DATE', length=601, freq=None)
Index([u'VALUE'], dtype='object')回答 2
Stack Overflow用户
回答已采纳
发布于 2017-04-12 19:33:03
您可以使用pandas.crosstab
df.DATE = pd.to_datetime(df.DATE)    # optional if the DATE column is already datetime type

pd.crosstab(df.DATE.dt.year,
            df.DATE.dt.strftime("%b"),
            df.VALUE,
            aggfunc="sum",
            rownames=["Year"],
            colnames=["Month"])
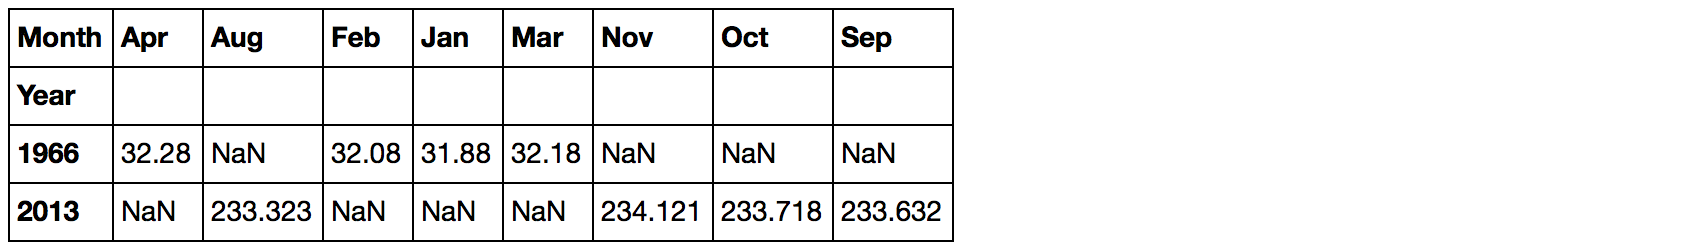
更新:万一您有日期作为索引:
pd.crosstab(df.index.year,
            df.index.strftime("%b"),
            df.VALUE,
            aggfunc="sum",
            rownames=["Year"],
colnames=["Month"])Stack Overflow用户
发布于 2017-04-12 20:50:15
我喜欢用pd.Series和unstack来构造这个
pd.Series(
    df.VALUE.values,
    [df.DATE.dt.year.values,
     df.DATE.dt.strftime("%b").values]
).unstack()

        Apr      Aug    Feb    Jan    Mar      Nov      Oct      Sep
1966  32.28      NaN  32.08  31.88  32.18      NaN      NaN      NaN
2013    NaN  233.323    NaN    NaN    NaN  234.121  233.718  233.632
或等效于
df.set_index(
    [df.DATE.dt.year,
     df.DATE.dt.strftime('%b')],
).VALUE.rename_axis([None, None]).unstack()
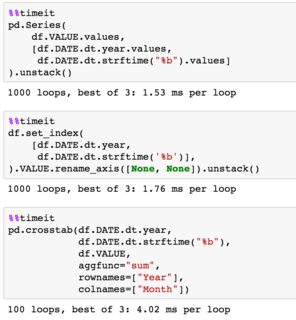
朴素定时
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/43377919
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号