
深度残差网络的直觉
我当时正在阅读深度剩余网络文件,其中有一个我无法完全理解的概念:
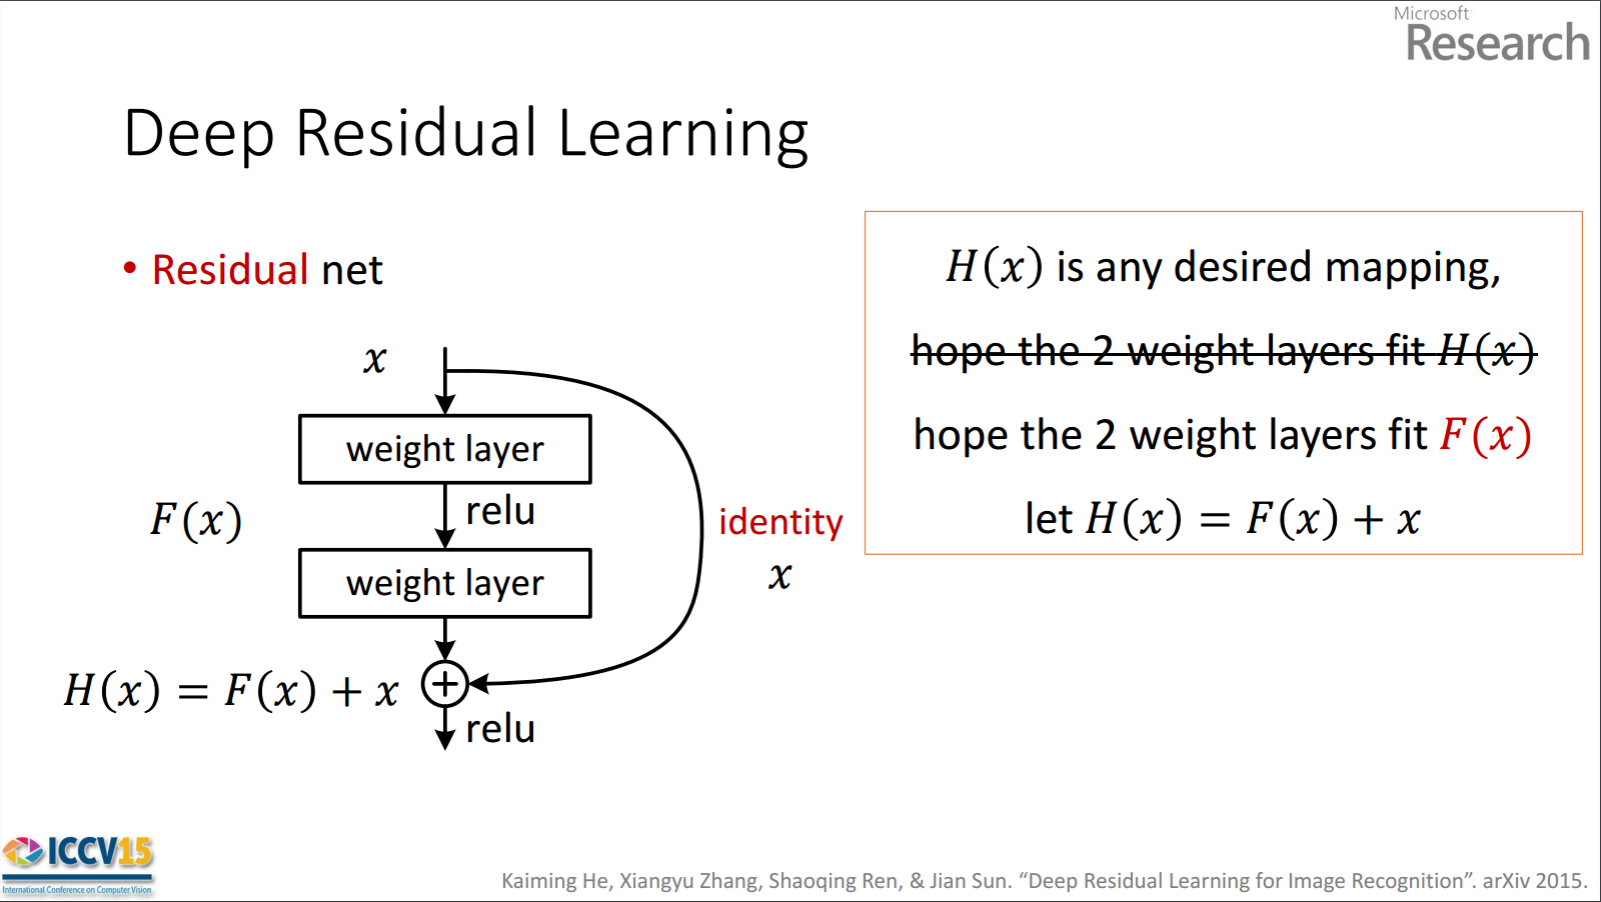
问题:
- 这是什么意思“希望两个重量层适合F(x)”?
- 这里F(x)处理具有两个权重层的x(+ ReLu非线性函数),所以所需的映射是H(x)=F(x)?残余物在哪里?
回答 1
Stack Overflow用户
发布于 2017-04-08 08:17:34
这是什么意思“希望两个重量层适合F(x)”?
因此,所示的残差单元通过处理具有两个权重层的F(x)来获得x。然后将x添加到F(x)中以获得H(x)。现在,假设H(x)是您理想的预测输出,它与您的实际情况相匹配。从H(x) = F(x) + x开始,获得所需的H(x)取决于获得完美的F(x)。这意味着剩余单元中的两个权重层实际上应该能够产生所需的F(x),然后保证得到理想的H(x)。
这里F(x)处理具有两个权重层的x(+ ReLu非线性函数),所以所需的映射是H(x)=F(x)?残余物在哪里?
第一部分是正确的。F(x)是从x获得的,如下所示。
x -> weight_1 -> ReLU -> weight_2H(x)是从F(x)获得的,如下所示。
F(x) + x -> ReLU 所以我不明白你问题的第二部分。残差为F(x)。
作者假设剩余映射(即F(x))可能比H(x)更容易优化。为了用一个简单的例子来说明,假设理想的H(x) = x。然后,对于直接映射,将很难学习身份映射,因为有如下所示的一堆非线性层。
x -> weight_1 -> ReLU -> weight_2 -> ReLU -> ... -> x因此,要用所有这些权重和中间的ReLU来近似标识映射是很困难的。
现在,如果我们定义了所需的映射H(x) = F(x) + x,那么我们只需要获得F(x) = 0,如下所示。
x -> weight_1 -> ReLU -> weight_2 -> ReLU -> ... -> 0 # look at the last 0实现上述目标很容易。只要将任何权重设置为零,您就会得到零输出。添加回x,您将得到所需的映射。
剩余网络成功的另一个因素是从第一层到最后一层的不间断梯度流。这超出了你的问题范围。有关此问题的更多信息,您可以阅读“深度残余网络中的标识映射”。
https://stackoverflow.com/questions/43290192
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号