
火花原理是“向数据发送代码”。这是什么意思?
火花原理是“向数据发送代码”。这是什么意思?
提问于 2017-03-15 00:54:21
火花原理是“向数据发送代码”。这是什么意思?为什么这比星火中的“发送数据到代码”更好、更高效?
回答 2
Stack Overflow用户
回答已采纳
发布于 2017-03-15 01:22:11
通常,Spark处理大量数据,并对其执行CPU密集型操作,例如转换或机器学习。它需要将数据保存在内存中。一台机器上的内存是有限的。因此,Spark将数据加载到多个节点中,并将算法发送到要在数据上执行的计算机。
此外,Spark还使用'n‘节点的CPU,而不仅仅是一个节点。
这样的数据我们通常被组织成密钥。我们需要计算大量客户的账户数据。这些可以在单独的节点上并行计算。所以有一个很大的性能增益。
一旦所有的计算都在节点上完成,来自每个节点的最终解决方案就可以在您的计算机上收集,或者更好的解决方案,如果是v大的话,写到NAS或HDFS上的输出文件。看见
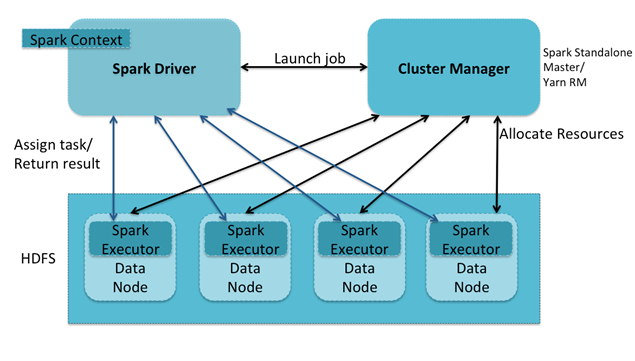
想出个主意。
Stack Overflow用户
发布于 2017-03-15 00:58:01
如果将数据发送到代码,则边缘节点是
- 读取所有数据
- 处理/过滤所有数据
- 把结果写在某个地方
另一种方法是边缘节点将代码发送到数据。
- 将代码写入数据节点
- 等待数据节点执行处理/筛选
- 等待数据已成功写入的确认
扩展性较好的原因很简单,有的数据节点多于边缘节点和的数据局部性意味着更好的性能。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/42799302
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号