
多元线性回归的梯度下降
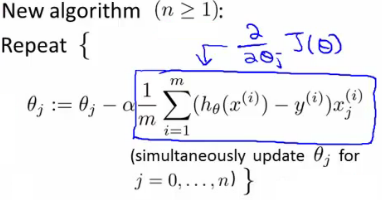
那么这个算法到底意味着什么呢?
我知道的:
(一)阿尔法:梯度下降的步骤有多大。
( ii)现在,∑{ hThetax(i) - y(i) }:指具有给定的Theta值的总错误。
误差是指预测值{ hThetax(i) }与实际值之间的差异。y(i)
hThetax{∑(I)- y(i) }给出了所有训练示例中所有错误的求和。
结尾的Xj^(i)代表什么?
我们在实现多元线性回归梯度下降时是否做了以下工作?
Theta (j)减:
- alpha
- 乘以1/m
- 时代:
{第一训练范例的误差乘以第一训练范例的jth元件。加号
第二次训练实例的jth元素对第二次训练实例的误差分析。加号
。
。
。
第n次训练实例的误差乘以第n次训练实例的jth元素。}
回答 1
Stack Overflow用户
发布于 2017-12-04 23:56:17
梯度下降是求函数最小值的迭代算法。当给定一个凸函数时,保证了给定足够小α的函数的全局极小值。下面是求函数J的最小值的梯度下降算法:
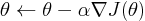
其思想是在学习速率α时,将参数向梯度相反的方向移动。最终,它将降到函数的最小值。
我们可以为θ的每个轴重写这个参数更新:
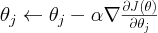
在多元线性回归中,优化的目标是最小化平方误差之和:
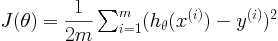
该成本函数的偏导数可以通过代换微分得到,其中我们使用初等幂规则,减去2到1的幂,并将2作为系数,消除了1/2系数。然后我们把h(x)的导数放到theta_j,也就是x_j在右边。
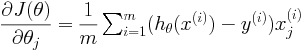
在这里,x_j^(i)是h_theta(x^(i))对theta_j的偏导数,x_j^(i)是I-数据的第j个元素。
https://stackoverflow.com/questions/42011781
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号