
将数据从hdf5数据集传输到numpy数组时的精度损失
将数据从hdf5数据集传输到numpy数组时的精度损失
提问于 2016-06-24 06:03:35
我正在尝试将数据从hdf5数据集(在下面的屏幕快照中的f_one)复制到一个numpy数组中,但是我发现我正在失去一些精度。
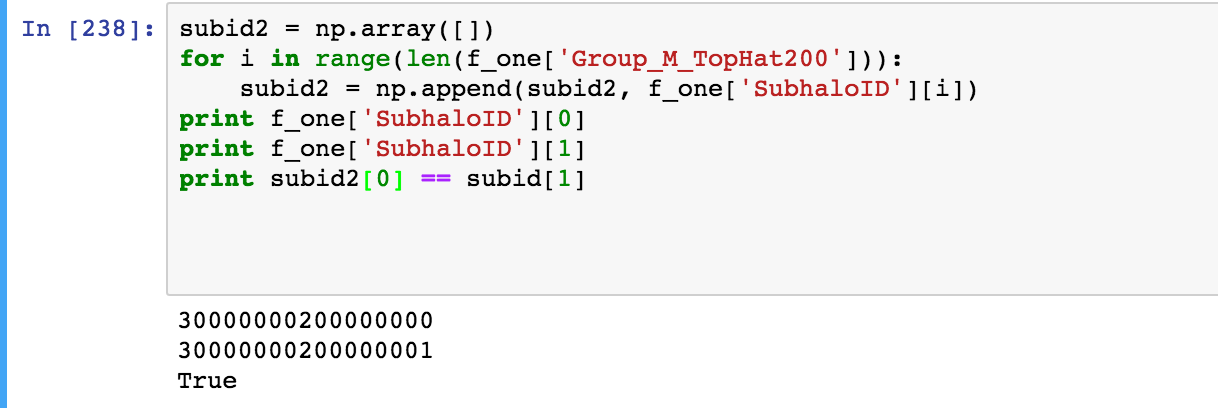
屏幕截图的最后一行(最后一次打印语句)应改为
subid2[0] == subid2[1].
我只是在拍截图之前不小心删除了2。输出是正确的。
正如您所看到的,Python似乎认为这两个数字完全相同,但是,当这两个数字包含在numpy数组中时,我需要精确地区分它们。有人知道我怎么能得到这种精确度吗?简而言之,我如何才能得到最后的打印语句来产生假的结果?
顺便提一下,以下几点:
f_one['SubhaloID'][0] == f_one['SubhaloID'][1]产生False。因此,在复制到numpy数组时会丢失一些精度。
回答 1
Stack Overflow用户
回答已采纳
发布于 2016-06-25 05:09:39
问题是您的输入是整数类型的,但是当创建一个numpy数组而不指定数据类型时,默认情况下您会将它们作为浮点数进行转换。要避免这种情况,请在为此数据创建numpy数组时使用dtype=np.int64。另一个选项是直接转换现有的整数数组,从而继承其条目的类型。
下面是一个简化的例子。
import numpy as np
a = [30000000200000000, 30000000200000001]
print(a[0]==a[1])           # False
b = np.array(a)
print(b[0]==b[1])           # False, direct conversion still has integers
c = np.array([])
for i in range(2):
    c = np.append(c, a[i])
print(c[0]==c[1])           # True, the entries are now floats
d = np.array([], dtype=np.int64)
for i in range(2):
    d = np.append(d, a[i])
print(d[0]==d[1]) # False, the entries were declared as integers检查使用type(c[0])和type(d[0])的类型以查看差异。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/38006541
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号