
星星之火sql正在工作,但似乎没有任何集群管理器,这是可能的?
我有一个hadoop集群,它有4个节点(1主节点,3节点)。我用hdfs中存储的文件创建了一些单元表。然后,我将mysql配置为蜂窝转移,并将hivesite.xml文件复制到星星之火的conf文件夹中。
要安装spark,我只需下载并提取主节点中的spark。在星星之火文件夹中复制hive-site.xml之后,我开始使用spark-shell command。它还需要在从节点中安装吗?
我问这个问题是因为,我成功地执行了如下所示的sql查询,但是如果我试图访问localhost:8080中的集群管理器默认页面,它会显示“无法连接”。因此,spark似乎运行良好,但是没有任何集群管理器,这是可能的吗??
var hiveContext = new org.apache.spark.sql.hive.HiveContext(sc)
query = hiveContext.sql("select * from customers");
query.show()
师父:8080
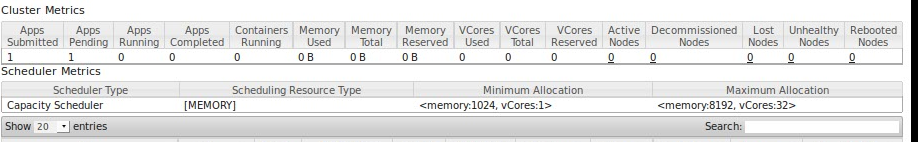
回答 2
Stack Overflow用户
发布于 2016-05-09 16:23:00
首先,您必须通过在星火-env.sh文件中设置env变量HADOOP_CONF_DIR,让spark知道Hadoop配置的位置。
然后,在启动spark-shell时,您必须告诉spark使用纱线作为主控:spark-shell --master yarn-client
有关更多信息,您可以看到火花与纱线文档
Stack Overflow用户
发布于 2016-05-09 16:07:01
- 您需要单独启动集群;默认情况下,shell在本地运行。
- 您还需要在工作节点上有火花二进制文件。
有关启动您自己的星火集群的文档,请参见此处:https://spark.apache.org/docs/latest/spark-standalone.html
https://stackoverflow.com/questions/37118052
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号