
Redis集群性能-低负载下的高超时率
看到红色集群的奇怪行为,它在大负载下完全正常工作,并且在低负载下开始以50%的超时率和不稳定的响应时间运行。
在低负荷时期,我们每天都有相同的模式。
有什么想法可以导致这种奇怪的模式吗?也许这个RedisCluster在低负载时间开始做一些维护工作?比如插槽再平衡。请推荐任何要检查的设置或方面。
版本: Redis 2.0.7,Jedis 2.8.1
配置:3个物理节点,9个主进程和18个从节点。
JedisCluster超时= 5ms。
Load是用setex写的100%。
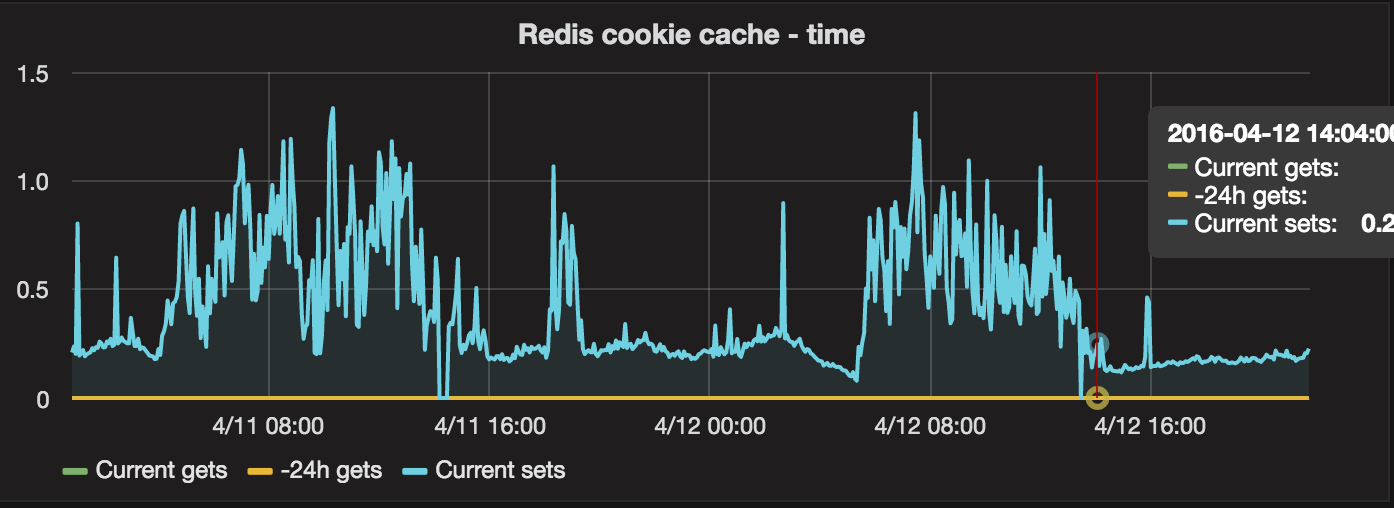
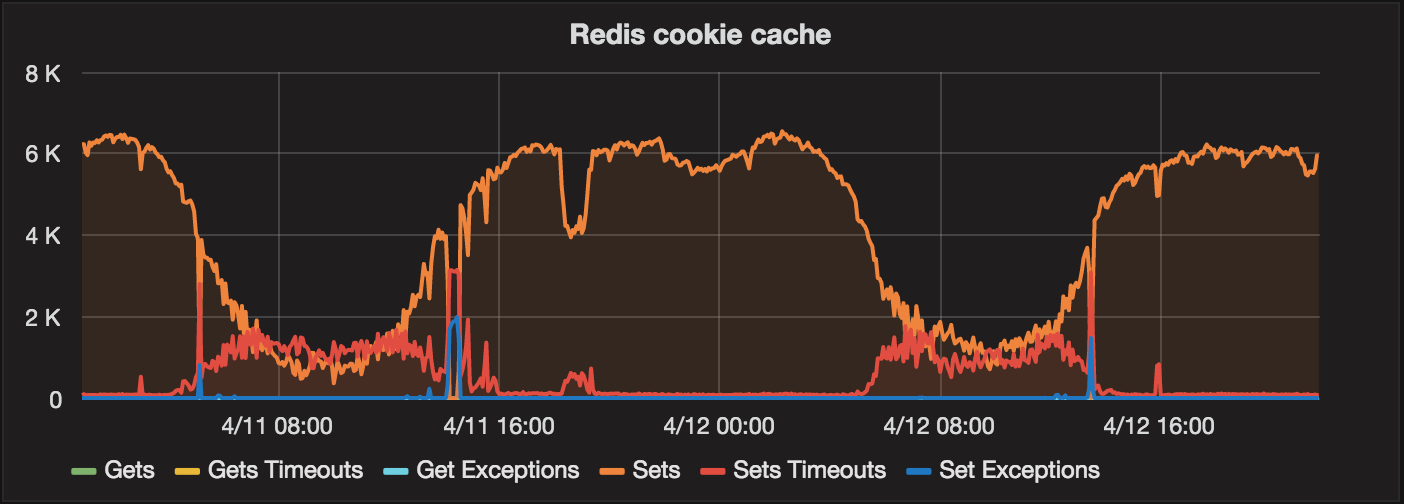
此图用于JedisCluster响应时间,而不是实际的RedisCluster时间。这里的“集合”线实际上是成功的集合,而不是总数。
回答 1
Stack Overflow用户
发布于 2016-04-19 12:39:23
最后,我发现它看起来像网络问题。
redis08(10.201.12.214) ~ $ redis-benchmark -h 10.201.12.215 -p 9006
====== PING_INLINE ======
  100000 requests completed in 91.42 seconds
  50 parallel clients
  3 bytes payload
  keep alive: 1

0.00% <= 11 milliseconds

redis09(10.201.12.215) ~ $ redis-benchmark -h 10.201.12.215 -p 9006
====== PING_INLINE ======
  100000 requests completed in 1.41 seconds
  50 parallel clients
  3 bytes payload
  keep alive: 1

99.46% <= 1 milliseconds

redis08 ~ $ ping lga-redis09
PING redis09 (10.201.12.215) 56(84) bytes of data.
64 bytes from redis09 (10.201.12.215): icmp_seq=1 ttl=64 time=10.7 ms
看看write的"if_octets“,在这个低写活动的时代,我们在网络接口上有着巨大的网络活动。与白天的负荷相比,夜间的负荷大约是10倍。
这是由于在这个低负载期开始主动交换信息的redis节点造成的。Iptraf顶部连接输出:
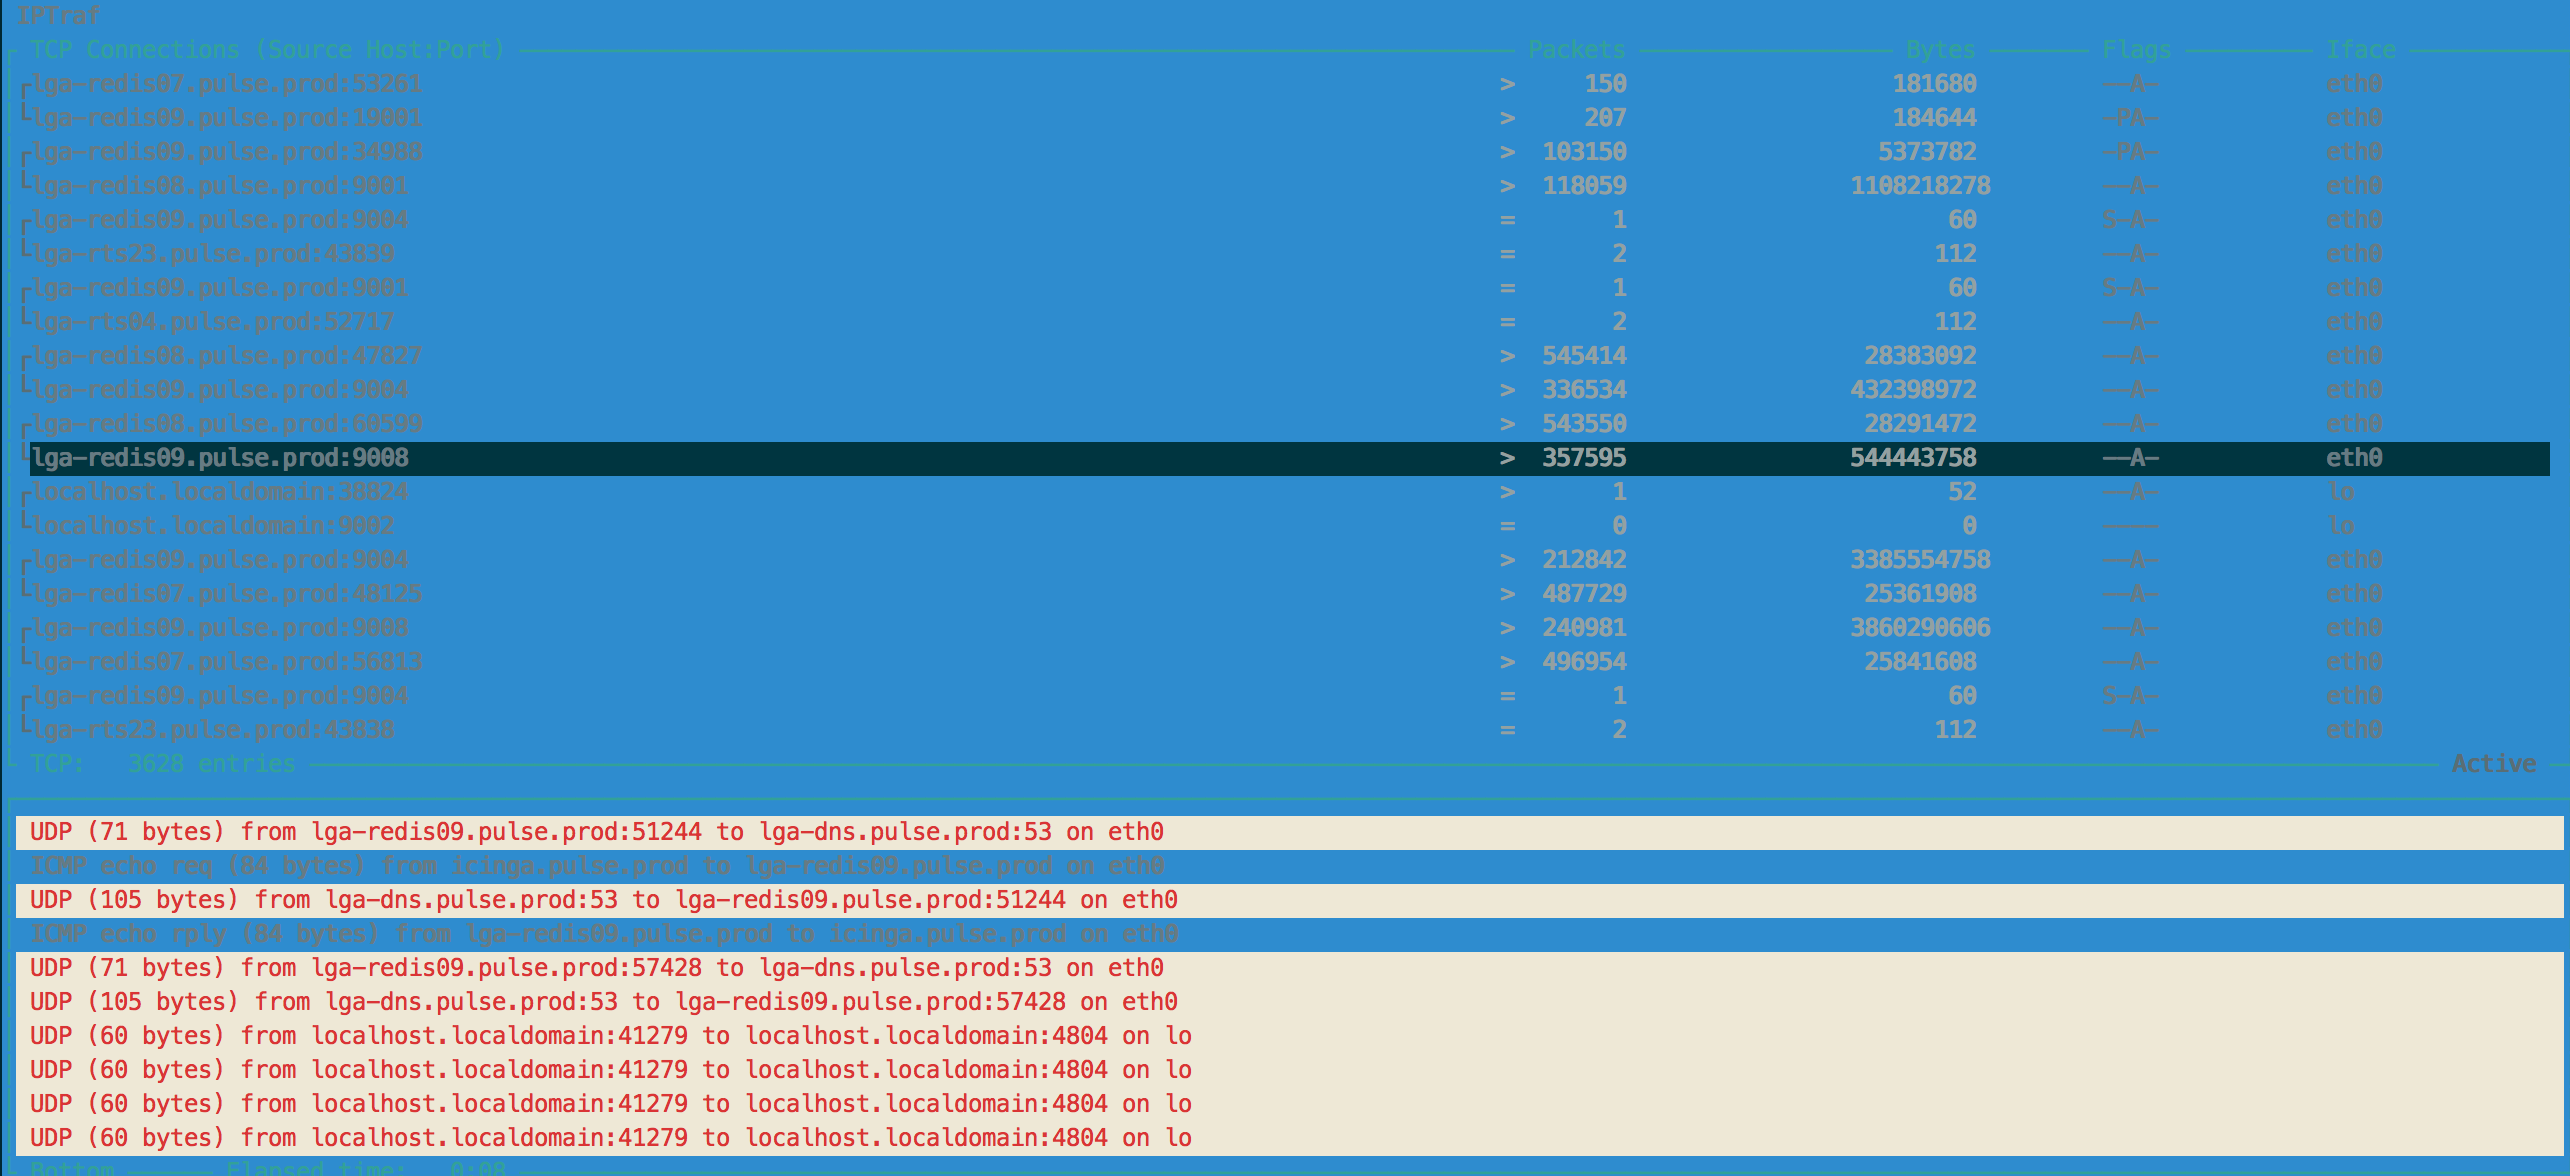
在白天,iptraf报告中的顶部完全属于实际的redis客户端,并且具有良好的写入负载。
最后发现我们在复制方面有问题。有时,缓冲区是不够的,奴隶开始完全重新整合。看起来就像今晚加载完全的重新同步尝试+低的repl超时值-结果是永无止境的复制尝试。为什么这种复制会对夜间的低负荷产生如此显著的影响,而不会影响白天的时间--我不知道,没有任何选项可以让redis更频繁地尝试晚上或诸如此类的事情。如果有趣的话,我们通过增加明显的设置来修复永无止境的复制:
repl-backlog-size
repl-timeouthttps://stackoverflow.com/questions/36583999
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号