
在C++中双哈希函数是如何工作的?
在C++中双哈希函数是如何工作的?
提问于 2016-02-24 04:35:23
我读到了关于HashTable的文章,找到了一个很好的来源,可以轻松地理解这里。。
但我对双哈希函数很困惑。以下是双哈希函数的细节。
双哈希使用在发生冲突时将第二个哈希函数应用于键的思想。第二个哈希函数的结果将是从碰撞点到插入点的位置数。 对于第二个功能有几个要求: 它绝不能计算为0,必须确保所有单元格都可以被探测。 流行的第二个散列函数是: Hash2( key ) =R-(键%R),其中R是小于表大小的素数。
这是双哈希函数的图像。
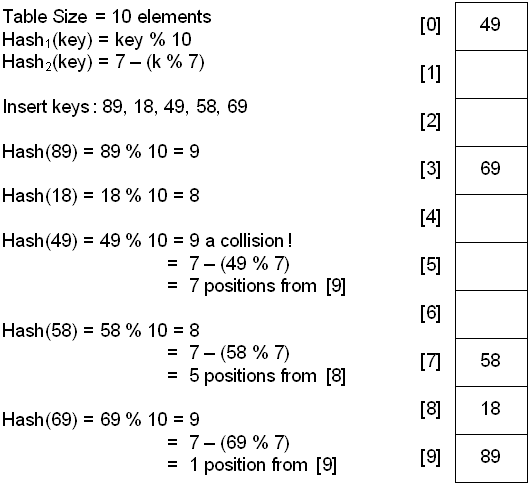
现在混乱开始了。就像他们说的那样。从7指数来看,49点应该在[9]头寸上。那么实际的位置是[6],那么他们为什么把49位放在[0]指数上呢?其他剩余整数也是如此。
当没有空索引时会发生什么呢?
回答 2
Stack Overflow用户
回答已采纳
发布于 2016-02-24 05:43:32
的确,图像是错误的。其基本思想是按第二位的值跳转,若已被占用,则继续按相同的位号跳跃。直到一个空的细胞被发现。要使此操作正常,第二个哈希函数不得返回0。
有关更多解释,请参见这里。
Stack Overflow用户
发布于 2016-02-24 05:17:36
图像是错误的,并且可能采用不同的散列方法。
当没有空单元时,您将不得不重新散列。请参见双哈希部分下面的“重散列散列”部分。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/35593353
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号