
MySQL连接器/J缓冲区在“流”ResultSet时行吗?
根据我的阅读,我看到使用ResultSet JDBC驱动程序在MySQL中流MySQL的方法是以下两个命令:
stmt = conn.createStatement(java.sql.ResultSet.TYPE_FORWARD_ONLY, java.sql.ResultSet.CONCUR_READ_ONLY);
stmt.setFetchSize(Integer.MIN_VALUE);我的问题是,专家能否澄清使用上述代码将ResultSet流返回给客户端,然后转到服务器获取下一行(效率极低),还是使用BufferedStreamReader这样的缓冲流是否足够聪明?如果它做缓冲流,如何设置缓冲区大小?
编辑:来自文档
前向只读结果集与取取大小Integer.MIN_VALUE的组合可作为驱动程序逐行流结果集的信号。之后,使用该语句创建的任何结果集都将逐行检索.
这是否意味着,如果我有10M行,那么就有10M个往返到服务器来获取这些行吗?这是非常低效的。我如何流ResultSet,但它有缓冲,以使我不必做这么多的往返?
EDIT2:当fetchSize设置为Integer.MIN_VALUE时,似乎MySQL会自动进行缓冲。在我的测试中,我能够使用setFetchSize(Integer.MIN_VALUE)在不到20分钟内读取超过4000万行。这相当于每秒30,000行。我不知道平均排得有多大,但很难想象每秒有3万次往返。
还有一个单独的问题:如果结果集有比fetchSize更多的元素,那么fetchSize会做什么?例如,结果集有10M行,fetchSize设置为1000。然后会发生什么呢?
回答 1
Stack Overflow用户
发布于 2016-02-15 15:04:43
当MySQL被设置为Integer.MIN_VALUE时,似乎会自动进行一些缓冲。
至少有时候是这样的。我使用Wireshark测试了MySQL连接器/J版本5.1.37的行为。为了桌子..。
CREATE TABLE lorem (
    id INT AUTO_INCREMENT PRIMARY KEY,
    tag VARCHAR(7),
    text1 VARCHAR(255),
    text2 VARCHAR(255)
    )
..。用测试数据..。
 id  tag      text1            text2
---  -------  ---------------  ---------------
  0  row_000  Lorem ipsum ...  Lorem ipsum ...
  1  row_001  Lorem ipsum ...  Lorem ipsum ...
  2  row_002  Lorem ipsum ...  Lorem ipsum ...
...
999  row_999  Lorem ipsum ...  Lorem ipsum ...

(where both `text1` and `text2` actually contain 255 characters in each row)
..。而密码..。
try (Statement s = conn.createStatement(java.sql.ResultSet.TYPE_FORWARD_ONLY, java.sql.ResultSet.CONCUR_READ_ONLY)) {
    s.setFetchSize(Integer.MIN_VALUE);
    String sql = "SELECT * FROM lorem ORDER BY id";
try (ResultSet rs = s.executeQuery(sql)) {..。在s.executeQuery(sql)之后(甚至在调用rs.next()之前),MySQL Connector/J已经从表中检索到了第一~140行。
实际上,当只查询tag列时
String sql = "SELECT tag FROM lorem ORDER BY id";MySQL连接器/J立即检索所有1000行,如网络帧的Wireshark列表所示:
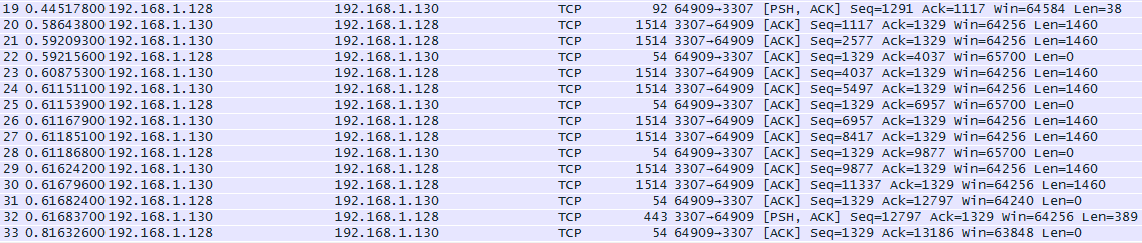
框架19将查询发送到服务器,如下所示:
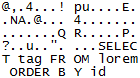
MySQL服务器响应帧20,从.
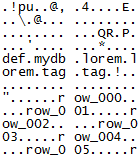
..。紧接着是第21帧,从.
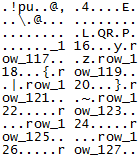
..。以此类推,直到服务器发送了帧32,该帧以
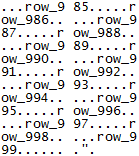
由于唯一的区别是每一行返回的信息量,因此我们可以得出结论,MySQL Connector/J根据返回的每一行的最大长度和可用的空闲内存量来决定适当的缓冲区大小。
如果结果集有比fetchSize更多的元素,那么MySQL会做什么?例如,结果集有10M行,fetchSize设置为1000。然后会发生什么呢?
MySQL连接器/J最初检索第一组fetchSize行,然后当rs.next()通过它们时,它将最终检索下一组行。即使对于setFetchSize(1)也是如此,顺便说一句,它实际上一次只能得到一行。
(注意,setFetchSize(n) for n>0需要连接URL中的useCursorFetch=true。这显然不是setFetchSize(Integer.MIN_VALUE)所必需的。)
https://stackoverflow.com/questions/35346229
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号