
Python3.4 integrate.quad dropoff
Python3.4 integrate.quad dropoff
提问于 2015-08-13 09:07:17
我试图计算python中高斯的积分,如下所示:
from math import exp
from scipy import stats, integrate
import scipy.interpolate as interpolate
from numpy import cumsum, random, histogram, linspace, zeros, inf, pi,sqrt
import matplotlib.pyplot as plt

A = 1
mu = 0
sigma = 1
p = lambda x: A * exp(-(((x-mu)**2))/(2*(sigma**2)))
F = lambda x: integrate.quad(p, -inf, x)[0]
Ns = 1000;
x = linspace(-50,50,Ns);
y = zeros(Ns)
yy = zeros(Ns)
for i in range(Ns):
    y[i] = F(x[i])
    yy[i]= p(x[i])

plt.plot(x,y)
plt.plot(x,yy)
plt.show()
但是,如果看一下这幅图,就会在21.0到22之间以及在38+之后降到零。有人知道它为什么要这么做吗?四舍五入的错误?
谢谢!!
回答 1
Stack Overflow用户
回答已采纳
发布于 2015-08-13 09:39:44
我认为理解这个问题的关键是回顾数值积分方法在特定节点上计算函数值的加权和。
当你偏离平均值时,高斯很快就会变成零,所以基本上,在(-50,50)之间的区间内,大部分函数值都是零。如果积分法不能从函数为非零的小区域中采样点,它将看到整个函数是完全平坦的,从而给出积分0。
那你能做什么?
与其选择(-50,50)的固定区间,不如根据较小的sigma值选择一个区间,以避免在过大的零点间隔上进行积分。
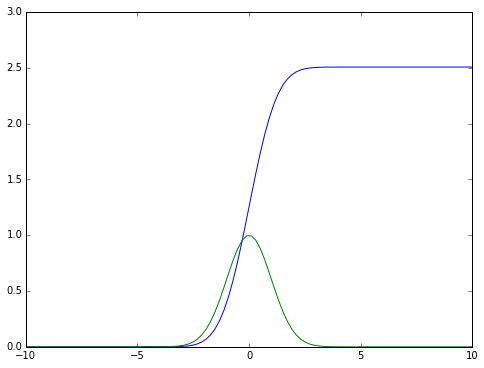
如果你只走5,10或20标准偏差向左和右,你将不会看到这个问题,你仍然有一个非常准确的积分结果。
这是结果,如果你从10个标准偏差,左和右。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/31983938
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号