
从表中读取值
从表中读取值
提问于 2015-07-25 10:33:42
我的问题是关于使用OCR从图像中的表中提取数据的post。
我使用tesseract将表图像转换为文本。这是很好的工作,除了表格的格式没有被保留。一种解决方案是用一些字母替换列,tesseract会识别并愚弄它,使它像一些文本一样接受表。
下面是一个没有列的表的示例
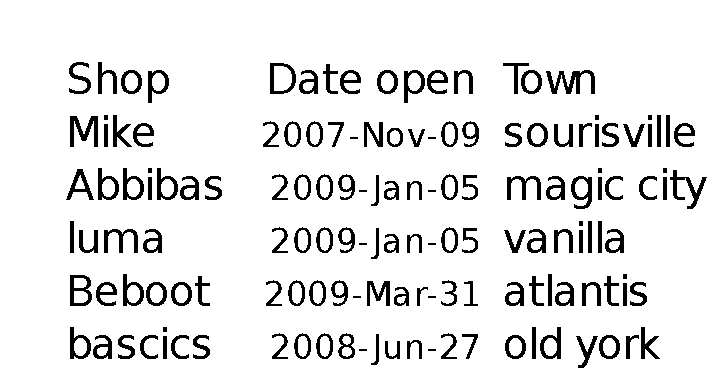
我使用以下代码绘制"QQ“列
im=Image.open("file.png")
draw  = ImageDraw.Draw(im)
font=ImageFont.truetype("/usr/share/fonts/gnu-free/FreeSerifBold.ttf",12)
by = font.getsize("S")[1]
col = [240,480]
px = []

for y in range(0,im.size[1],by):
    for x in col:
        draw.text((x,y),"QQ",font=font,fill=0)

im.save("res-file.png")
im.show()
它给了我以下图像
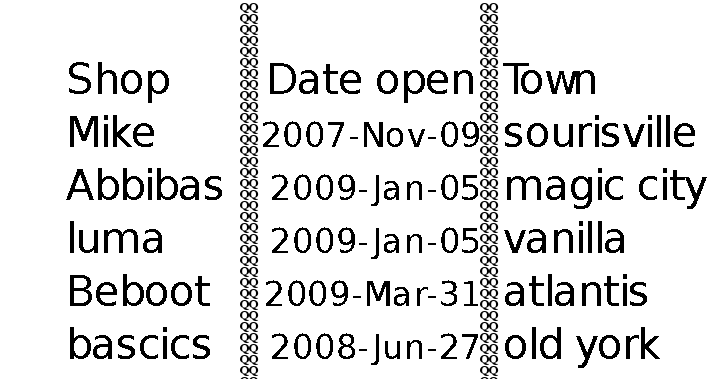
问题是,tesseract甚至认不出QQ。我也把QQ列写在一个空白页上,而tesseract不认识它。
有没有一种方法可以使用tesseract将这个png格式的表转换成文本?有什么东西让我逃脱了吗?
回答 1
Stack Overflow用户
回答已采纳
发布于 2015-07-27 13:01:25
主要问题是QQ的垂直间距。通过添加一些垂直间距和调整图像大小,我得到了可接受的结果。
im=Image.open("file.png")
draw  = ImageDraw.Draw(im)
font=ImageFont.truetype("/usr/share/fonts/gnu-free/FreeSerifBold.ttf",12)
by = font.getsize("S")[1]
col = [240,480]
px = []

for y in range(0,im.size[1],by+5):
    for x in col:
        draw.text((x,y),"QQ",font=font,fill=0)
im=im.resize((im.size[0]*2,im.size[1]*2))
im.save("res-file.png")
im.show()以下是tesseract res-file.png outputfile之后获得的文本
八八八八
八八八八
商店§开放日期§城镇
Mike§2007-11月-09年
Abbibas§2009-1月-05§魔术城
Iuma $2009-05年1月-05§vani\x{e76f}a
Beboot§2009-3月-31节
基础材料$2008-6月-27§o\d york
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/31625537
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号