
哈希表,每个哈希表单元格上的相同记录。
文本文件中有一个单词字典。我会把这些话都说出来的。我写了一些代码,但有一个问题。最后一个词发生在每个哈希表记录上。
main()
{
   FILE *fp;
   char word[100];
   char *hash[569];
   int i;
   for(i=0;i<569;i++)
      hash[i]="NULL";


   int m=569;
   int z =569;
   int mm=568;
   char w;

   int key;
   int j;
   int hash1;
   int hash2;
   fp=fopen("smallDictionary.txt","r");
   int counter =0;
   while(fscanf(fp,"%s",word)!=EOF)
   {
    j=0;
    counter++;

      for(i=key=0;i<strlen(word);i++)
         key+=(word[i]-'a')*26*i;
      hash1=key%m;
      hash2=1+(key%mm);
      while(hash[(hash1+j*hash2)%m]!="NULL")
      {
             j++;
      }
      hash[(hash1+j*hash2)%m] = word;
   }

  for(i=0;i<569;i++)
      printf("%s ",hash[i]);

   fclose(fp);
}
在控制台上结束结果。
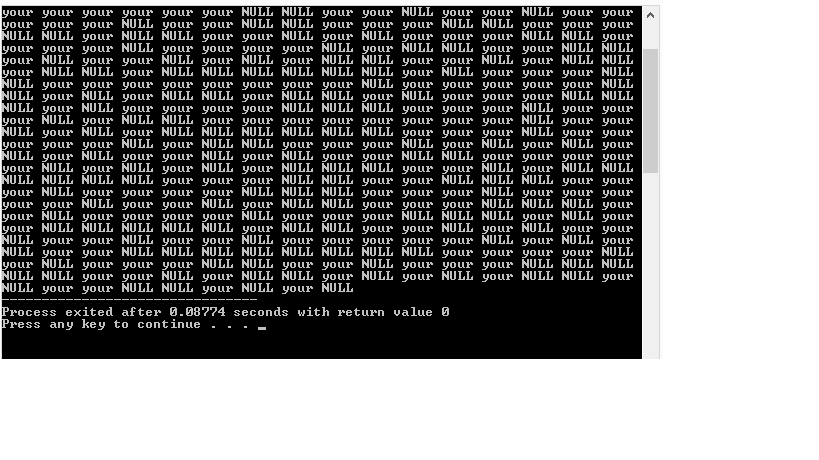
正如它所看到的,作为字典的最后一个词,"your“关键字重复出现。
字典内容:
关于上述绝对可接受的添加算法后,算法也一直在分析和任何作为赋值假设的任何参数都在鸟体以下,但可由不能大写的案例、中心链链、更改字符检查、检查检查、选择类代码碰撞、冲突命令编译、编译复杂性、包含包含方便转换、更正、创建跨处理调试、确定扣除删除的部门字典、发现每个动态最容易遇到的文件、最容易遇到的错误、错误等,甚至是可执行的可执行文件、扩展体验因子、公平的秋季文件文件,首先找到四个星期五的字体。从功能函数g获得一般生成生成的geoff网格,给好的分级机生长指南,有头发柄,有散列散列,有头标题,帮助保持作业小时,我如果在包括不正确的信息输入,插入插入,插入说明,在ispell,它保持已知的昆宁,最后的字母,较少的字母,如线线性列表负载,长时间,最长看起来低,保持了很多匹配,可能会出现更多的匹配,午夜可能会出现拼写错误模式,最重要的是,我的名字,必要的,永远不要下一个选项,或原始的其他输出页面的一对踏板点,只要一个选项或原始的其他输出页面的脚踏点。政策可能更倾向于初级探测问题的产生,产生教授程序目的,二次快速阅读理由,合理参考,重新哈希,重新初始化报告,重新提交,重新提交,分离,严重的分开,类似简单简化单个尺寸,所以一些规范,拼写,标准统计,强提交,成功提交,建议支持假设表技术,比他们,这三次到周四的题目在一起,传统的牙齿轨迹,传统的转移试验,尝试图灵德,不理解,用常用的变体,使用常用的变体,墙壁警告是我们的方式,当谁的白空格,为什么会狂野的警告是我们的方式。电线杆用文字写错你的作品
回答 1
Stack Overflow用户
发布于 2015-04-26 12:17:09
hash[(hash1+j*hash2)%m] = word;它只是将word的地址分配给哈希条目。总是一样的。在循环的末尾,word的内容显然将是fscanf读取的最后一个内容。所以你需要这样的东西:
hash[(hash1+j*hash2)%m] = strdup(word);strdup分配堆内存,所以不要忘记在哈希表不再需要时释放它。
https://stackoverflow.com/questions/29877460
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号