
同时绑定两列数据
同时绑定两列数据
提问于 2015-03-29 15:17:31
我有两列数据,一列包含一组值,另一列包含相应的pearson系数值(都是41306329长)。我想将我的数据存储到第一列,这样,任何在一个设定的bin范围内的值也都包含在这些回收箱中的相应的pearson系数值中。但是,一旦这样做了,我想把那些皮尔逊系数值。例如:
column1 <- as.numeric(c("100.01", "100.015", "100.017", "100.071", "100.099", "100.111", "100.153", "100.167"))
column2 <- as.numeric(c("0.89", "0.64", "-0.14", "-0.79", "1", "0.31", "-0.27", "0.45"))
test <- cbind(column1, column2)
bin1 <- seq(100, 100.2, by = 0.05)
bin2 <- seq(-1, 1, by = 0.5)
我需要一种方法来存放这些值,这样我就可以得到(100,100.05)(100.05,100.1)(100.1,100.15)(100.15)(100.15,100.2),在将它们相应的pearson系数值从-1绑定到+1之前,生成一个三维散点图,用pearson系数值描述从第一列到第一列的值的分布。实际上,它将产生一个值图(column1)与皮尔逊系数(column2)比频率。
图看起来会是这样的:-
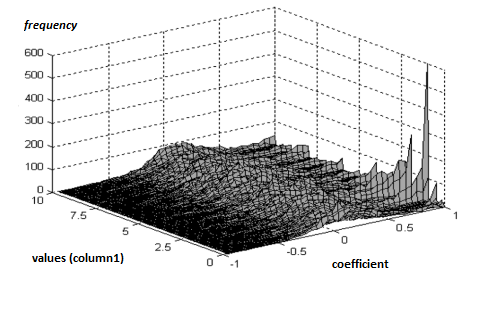
我希望这是合理的!谢谢!
回答 1
Stack Overflow用户
回答已采纳
发布于 2015-03-29 15:21:35
你可以试试
 res <- data.frame(Map(function(x,y) cut(x, breaks=y),
                    as.data.frame(test), list(bin1, bin2)))

res1 <- cbind(test, res)页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/29330878
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号