
我可以不使用re.DOTALL来匹配python中的多行字符串吗?
我试图用python编写一个简单的lexer。我用正则表达式来做这件事。因此,我需要一个与多行注释相匹配的正则表达式:
/* first line.
the second line
The last line. */
通过使用此模式:
pattern = r"/\*.*\*/" 和编译它与
regex = re.compile(pattern,re.DOTALL) 它起作用了。
现在,我将不使用re.DOTALL,因为这也适用于单引号字符串。
回答 3
Stack Overflow用户
发布于 2015-03-12 21:52:55
您可以通过使用像这个[\s\S]这样的小技巧来达到同样的目的。
[\s\S]背后的想法是捕捉一切,这样就可以使用显式模式来划分您想要的内容。例如:
/\*        <--- Match /*
[\s\S]*?   <--- Match everything (ungreedy)
\*/        <--- Match */
您可以使用这样的正则表达式:
/\*[\s\S]*?\*/如果要捕获注释中的内容,则可以:
/\*([\s\S]*?)\*/您可以在下面看到这个技巧是如何工作的:
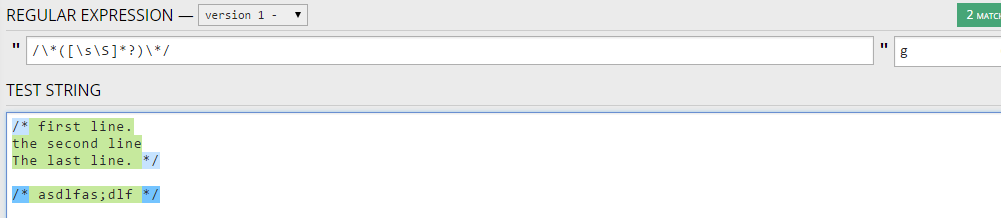
顺便说一句,您使用的是一个贪婪的正则表达式/\*.*\*/,它将错误地匹配注释。例如,如果您有:
/* A */
/* B */您将错误地匹配/* A *//* B */。必须添加?才能将其设置为不贪婪,如下所示:
/\*.*?\*/
^--- ungreedyStack Overflow用户
发布于 2015-03-12 21:53:16
对于re.XXX常量,也可以使用内联标志:
re.match('(?s)/\*.*?\*/', stuff)来自文档
(?iLmsux) (集“i”、“L”、“m”、“s”、“u”、“x”中的一个或多个字母)。组匹配空字符串;字母为整个正则表达式设置相应的标志: re.I (忽略大小写)、re.L (取决于地区)、re.M (多行)、re.S (点匹配所有)、re.U (取决于Unicode)和re.X (详细)。
与re.XXX标志相比,我更喜欢内联,原因有两个: 1)表达式是独立的,2)不需要使用compile或将flags param附加到每个re.调用。
Stack Overflow用户
发布于 2015-03-12 22:01:06
如果我们想列举所有可能的情况,我也会发布我的答案:
/\*(?:[\r\n]|[^\r\n])*\*/
见这里的例子。
但是,使用示例计算需要147个步骤,而Fede的/\*[\s\S]*\*/只需要12个步骤。
如果我们比较捕获组( /\*((?:[\r\n]|[^\r\n])*)\*/ )和捕获组( /\*([\s\S]*?)\*/ )之间的性能,那么这个比例已经没有那么大:151个步骤和97个步骤。
https://stackoverflow.com/questions/29020866
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号