
OCR最小字符大小
我正在计划一个相机的属性,我需要一个计算机视觉系统。我必须检测图像中的一些字母数字区域,然后使用Tesseract和OpenCV将它们与OCR进行转换。一个典型的例子可能是高速公路上的车牌识别(但在我的项目中,速度是没有问题的)。
为了估计相机的分辨率,我需要知道镜头的距离和焦距,这可能是文本像素中的最小高度,以获得可靠的OCR转换。
利用薄透镜方程,得到了文本高度( mm )与文本高度(像素)之间的关系。改变相机的距离或焦距,我得到不同的高度在我的文字像素(从10像素到40像素)
当然,我更喜欢字符高度为40像素,但这也是最昂贵的解决方案。
出于这个原因,我想知道OpenCV和Tesseract库是否为文本的最小可靠大小设置了一些约束以获得良好的识别。我读过不同的商业OCR推荐字符大小在25到40像素之间。这个范围是否也适用于Tesseract/OpenCV?
我做了两个小字符大小的测试(15 px)和OCR工作非常好,但当然有理想的条件,光,对比度和背景色。
回答 1
Stack Overflow用户
发布于 2014-12-16 00:12:27
大多数车牌读取(ALPR)算法使用边缘信息和分类来确定特定的符号( alpha、数字或其他语言符号)。考虑到这一点,边缘需要在厚度和足够的对比度中得到很好的定义。
正如OP商业ALPR算法所提到的,字符高度建议至少有20个像素。这将确保大多数用于车牌的标准字体类型的边缘至少为x像素。这里是一个车牌的例子,字符高度约为25像素-边缘至少有3像素宽。拥有定义良好的边缘将有助于大多数ALPR算法。虽然过度锐度并不一定有助于提高ALPR的性能,因为一定数量的模糊反正是为了消除噪声,在边缘和连接组件被检测之前。
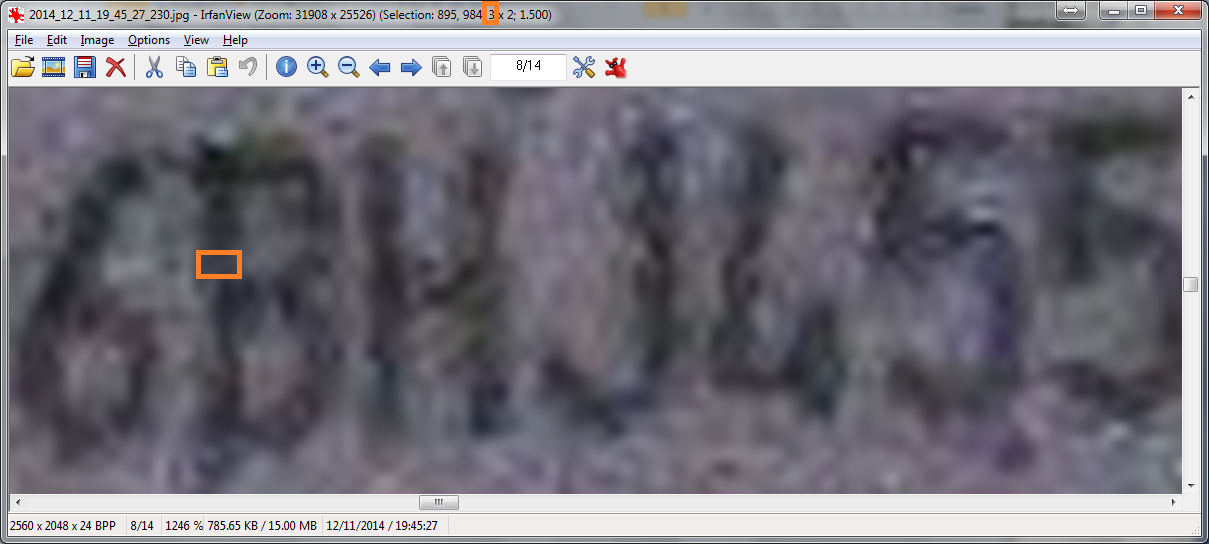
更高的对比度(改善的照明条件)和图像的最佳分辨率(字符大小至少20个像素,但不太高)将有助于提高ALPR算法的速度。
https://stackoverflow.com/questions/27489735
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号