
如何将数据从scrapy插入到mysql
我正在尝试使用scrapy从amazon获取数据,我可以在CSV中获得数据,但是我无法在mysql数据库中插入数据,请找到我的代码,我的蜘蛛是。
import scrapy
from craigslist_sample.items import AmazonDepartmentItem
from scrapy.contrib.spiders import CrawlSpider, Rule
from scrapy.contrib.linkextractors import LinkExtractor

class AmazonAllDepartmentSpider(scrapy.Spider):

    name = "amazon"
    allowed_domains = ["amazon.com"]
    start_urls = [
        "http://www.amazon.com/gp/site-directory/ref=nav_sad/187-3757581-3331414"
    ]
    def parse(self, response):
        for sel in response.xpath('//ul/li'):
            item = AmazonDepartmentItem()
            item['title'] = sel.xpath('a/text()').extract()
            item['link'] = sel.xpath('a/@href').extract()
            item['desc'] = sel.xpath('text()').extract()
        return item
我的管道代码是
import sys
import MySQLdb
import hashlib
from scrapy.exceptions import DropItem
from scrapy.http import Request

class MySQLStorePipeline(object):


    host = 'rerhr.com'
    user = 'amazon'
    password = 'sads23'
    db = 'amazon_project'

    def __init__(self):
        self.connection = MySQLdb.connect(self.host, self.user, self.password, self.db)
        self.cursor = self.connection.cursor()

    def process_item(self, item, spider):
        try:
            self.cursor.execute("""INSERT INTO amazon_project.ProductDepartment (ProductDepartmentLilnk)
                            VALUES (%s)""",
                           (
                            item['link'].encode('utf-8')))

            self.connection.commit()

        except MySQLdb.Error, e:
            print "Error %d: %s" % (e.args[0], e.args[1])
        return item
当我按照命令运行时
爬行亚马逊-o items.csv -t csv
然后我可以在CSV中获得数据,但是当我运行时
爬行亚马逊
使用上面的代码,我无法在mysql中插入数据。
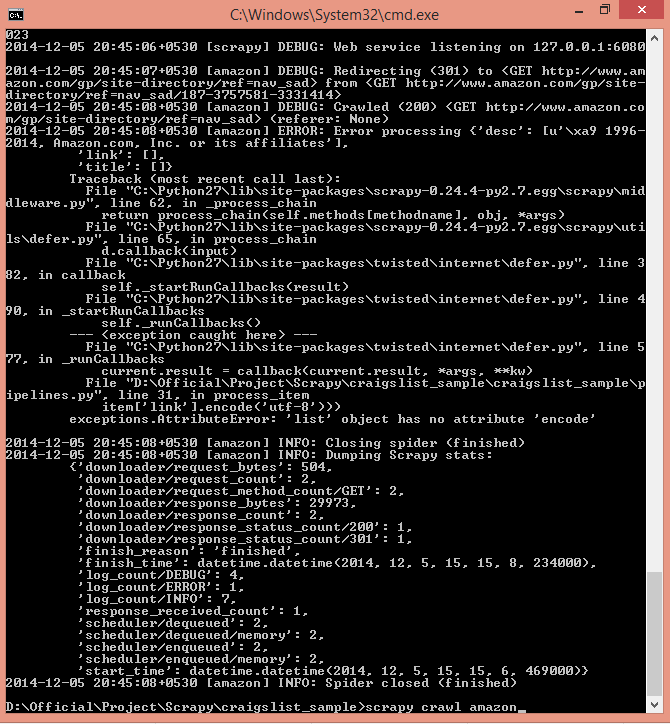
所以请帮我做些什么,然后我可以在mysql中插入数据。
谢谢
回答 1
Stack Overflow用户
发布于 2014-12-05 15:22:29
问题实际上是在parse()回调中。extract()调用返回一个list,因此所有item字段值都变成list。然后,管道中的item['link'].encode('utf-8')调用失败,因为列表中没有encode()方法。
一个快速而简单的解决方法是获取extract()调用结果的第一个元素:
def parse(self, response):
    for sel in response.xpath('//ul/li'):
        item = AmazonDepartmentItem()
        item['title'] = sel.xpath('a/text()').extract()[0]
        item['link'] = sel.xpath('a/@href').extract()[0]
        item['desc'] = sel.xpath('text()').extract()[0]
yield item请注意,我还将return item表达式替换为yield item,并将其放入循环中。
更好的方法是定义具有输入和输出处理器的ItemLoader。
from scrapy.contrib.loader import ItemLoader
from scrapy.contrib.loader.processor import TakeFirst

class ProductLoader(ItemLoader):
default_output_processor = TakeFirst()FYI,以下是TakeFirst()所做的工作:
从接收到的值返回第一个非空/非空值,因此它通常用作单值字段的输出处理器。它不接收任何构造函数参数,也不接受Loader上下文。
然后,parse()方法将转换为:
def parse(self, response):
    for sel in response.xpath('//ul/li'):
        l = ItemLoader(item=AmazonDepartmentItem(), selector=sel)
        l.add_xpath('title', 'a/text()')
        l.add_xpath('link', 'a/@href')
        l.add_xpath('desc', 'text()')
yield l.load_item()https://stackoverflow.com/questions/27318735
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号