
计算项目在不同时间范围内的平均分钟数
计算项目在不同时间范围内的平均分钟数
提问于 2014-10-29 18:25:27
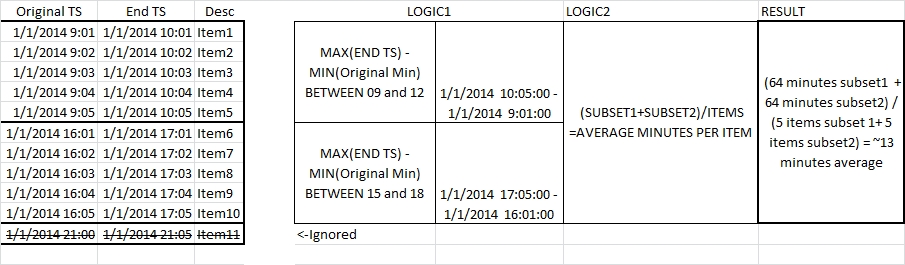
我有一个数据集,需要分成两个子集。每个子集必须仅包括特定时间范围内的项。然后,我需要取最大(上次编辑的时间)-MIN(项目添加时间),并除以子集中的项目数量。因此,我的目标是计算在两个时间框架内处理所有项目所需的平均时间。看这张照片!
我尝试过这样做,但结果似乎不正确;查询在WHERE子句中为MIN和MAX生成整个时间段的结果(因此,多天的时间会极大地破坏结果)。
SELECT
  CASE
    WHEN TO_CHAR(ADDED, 'HH24') BETWEEN 09 AND 11
    THEN TRUNC(((MAX(MODIFIED) - MIN(ADDED))*24*60)/COUNT(TRANSACTIONS))
    ELSE 0
  END
    +
  CASE
    WHEN TO_CHAR(ADDED, 'HH24') BETWEEN 15 AND 19
    THEN TRUNC(((MAX(MODIFIED) - MIN(ADDED))*24*60)/COUNT(TRANSACTIONS))
    ELSE 0
  END AS subsets_average
FROM TABLE回答 1
Stack Overflow用户
回答已采纳
发布于 2014-10-29 18:44:55
我明白你想做什么了。case语句在错误的位置。您需要聚合函数中的条件:
SELECT TRUNC(((MAX(MODIFIED END)-
               MIN(ADDED ))*24*60)/COUNT(TRANSACTIONS) as grand_average,
       TRUNC(((MAX(TO_CHAR(ADDED, 'HH24') BETWEEN 09 AND 11 THEN MODIFIED END)-
               MIN(TO_CHAR(ADDED, 'HH24') BETWEEN 09 AND 11 THEN ADDED END))*24*60)/COUNT(TRANSACTIONS)
             ) +
       TRUNC(((MAX(TO_CHAR(ADDED, 'HH24') BETWEEN 15 AND 19 THEN MODIFIED END)-
               MIN(TO_CHAR(ADDED, 'HH24') BETWEEN 15 AND 19 THEN ADDED END))*24*60)/COUNT(TRANSACTIONS) AS subsets_average
FROM TABLE页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/26637976
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号