
图像文本识别
想象一下这样一个短片:黑色背景,中间的一行白色文字逐渐被红色填充,不仅是一个字母,而且每个单独的字母都是逐渐填充的。下面是一个简化的图像,它说明了这一点:
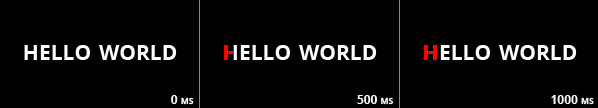
(中间有很多帧,但为了简单起见,它们被省略了。)
因此,经过一段时间(大约10秒),整个字符串将是红色的。
现在我要解决的任务是:
- 我必须识别初始字符串,因此我应该得到"HELLO“作为结果。
- 不仅如此。对于每一封信,我都要找出它在哪一点上星星被填满了,在什么时候它被完全填满了。
输出可能如下所示:
H,0ms,1000ms E,1000ms, 1500ms L,1500,2500ms L,2500ms,3500ms O,3500ms,4000ms
..。诸若此类。
不同字母的速度可能不同。字体和字体大小总是一样的。字符集包括小写和大写字母。
我考虑了两种方法: OCR识别或神经网络。我对这两者都没有什么经验。
我假定OCR方法将使我很容易识别文本。但是我如何识别没有填充的字母和填充的字母?
神经网络方法可能会让我识别出两个未填充/填充的字母,但为此,我必须将图像分割成单独的字母,这本身可能是一个复杂的任务。
还有其他选择吗?或者,考虑到以上两种选择,您会推荐哪一种,以及如何解决为这两种方法概述的问题?
回答 3
Stack Overflow用户
发布于 2014-08-16 12:36:45
虽然使用一个特别调优的OCR或其他类型的图像识别算法将是最有效的方法,它可能会涉及到大量的工作在您的一方,以获得正确。
与其这样做,不如使用一个简单的图像过滤器,把每一帧分割成两层。一层白色部分变成黑色,一层红色部分变成黑色。在第三个示例帧中,第一层将只包含黑色背景中的红色H,而第二层将在黑色背景中包含白色ELLO WORLD。
然后,您可以使用OCR算法从每个层获取字母,清楚地分为填充组和未填充组。在原始帧上使用OCR会给出整个文本,这样就可以很容易地处理部分填充的字母在两层中显示(损坏)。
根据您的性能要求,这可能足以满足您的需要,尽管必须运行三倍于OCR算法的.
Stack Overflow用户
发布于 2014-08-17 15:29:05
Stack Overflow用户
发布于 2014-08-19 00:24:18
我在一个强大的商业OCR应用程序中测试了你的形象。为了简单起见,我同时测试了所有三个框架,因为这对一次或一次阅读没有任何影响。分段处理这一点,并分别读取每个区域。结果如下(忽略蓝色高光):
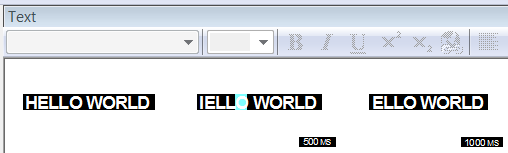
你看到的是真正的数字字符/字符串。该软件检测到黑色背景上的白色文本。又称倒置文本。
我在测试之前所关注的问题,以及测试所证实的,是关于那些部分填充的字符。OCR将读取文本和任何看起来像文本的内容。你可能会得到部分字符读起来像我(见上面在第二帧),分号(部分C),周期(部分L),V(部分W)等,只要你过滤那些我想.
我相信OCR对于快速原型或一次性需求来说是一个更容易的选择,但它可能不精确到毫秒,可能会产生一些原始的结果,需要通过额外的决策和过滤器进行“后处理”。
完全可靠的方法将是图像和像素分析。正如您所说,在实际像素分析开始之前,还需要一些额外的步骤。
因此,最后,我认为这两者对于一个优雅和可靠的解决方案是必要的。
这个怎么样:
- 使用第一帧(一个没有红色像素)获得整个字符串使用OCR,加上每个字符的坐标包围框。(您没有留下,但似乎字符的位置在不同帧之间保持完全相同。)我测试的OCR系统为您提供了XML中每个字符的精确坐标。其他OCR也应该能够做到这一点。
- 从左边开始,分析每个字符包围框(将每个字符当作一个小的单独图像,宽和高,但要使用精确的坐标),以显示至少一个红色像素。砰-那是你那个角色的开场白。
- 分析最后一个白色像素的相同框。砰-那是你填补那个角色的最后一步。
对所有字符重复。
每个步骤都使用相对简单的可用工具,简单的定义良好的算法,并且应该产生高度的一致性和可靠性。
https://stackoverflow.com/questions/25339736
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号