
熊猫级别名称的多索引切片
最新版本的Pandas支持多索引切片器。但是,需要知道不同级别的整数位置才能正确使用它们。
例如:
idx = pd.IndexSlice
dfmi.loc[idx[:,:,['C1','C3']],idx[:,'foo']]假设我们知道第三个行级别是我们希望用C1和C3索引的级别,而第二个列级别是我们希望用foo索引的级别。
有时,我知道级别的名称,但不知道它们在多个索引中的位置。在这种情况下,是否有一种使用多索引片的方法?
例如,假设我知道我想在每个级别的名称上应用什么片,例如作为字典:
'level_name_1' -> ':'
'level_name_2' -> ':'
'level_name_3' -> ['C1', 'C3']但我不知道这些层次在多个指数中的位置(深度)。Pandas是一个内置的索引机制吗?
如果我知道级别名称,但不知道它们的位置,我还能以某种方式使用pd.IndexSlice对象吗?
PD:我知道我可以使用reset_index(),然后只使用平面列,但我希望避免重新设置索引(即使是暂时的)。我也可以使用query,但是query需要索引名与Python标识符兼容(例如,没有空格等)。
我所看到的最接近上述情况的是:
df.xs('C1', level='foo')其中foo是级别的名称,C1是感兴趣的值。
我知道xs支持多个键,例如:
df.xs(('one', 'bar'), level=('second', 'first'), axis=1)但是它支持,而不是支持片或范围(就像pd.IndexSlice一样)。
回答 3
Stack Overflow用户
发布于 2014-06-09 18:37:58
这仍然是一个有待改进的问题,请参阅这里。支持这一点是非常简单的。拉-请求是欢迎!
您可以轻松地作为一个解决方案来完成这个任务:
In [11]: midx = pd.MultiIndex.from_product([list(range(3)),['a','b','c'],pd.date_range('20130101',periods=3)],names=['numbers','letters','dates'])

In [12]: midx.names.index('letters')
Out[12]: 1

In [13]: midx.names.index('dates')
Out[13]: 2
下面是一个完整的例子
In [18]: df = DataFrame(np.random.randn(len(midx),1),index=midx)

In [19]: df
Out[19]:
                                   0
numbers letters dates
0       a       2013-01-01  0.261092
                2013-01-02 -1.267770
                2013-01-03  0.008230
        b       2013-01-01 -1.515866
                2013-01-02  0.351942
                2013-01-03 -0.245463
        c       2013-01-01 -0.253103
                2013-01-02 -0.385411
                2013-01-03 -1.740821
1       a       2013-01-01 -0.108325
                2013-01-02 -0.212350
                2013-01-03  0.021097
        b       2013-01-01 -1.922214
                2013-01-02 -1.769003
                2013-01-03 -0.594216
        c       2013-01-01 -0.419775
                2013-01-02  1.511700
                2013-01-03  0.994332
2       a       2013-01-01 -0.020299
                2013-01-02 -0.749474
                2013-01-03 -1.478558
        b       2013-01-01 -1.357671
                2013-01-02  0.161185
                2013-01-03 -0.658246
        c       2013-01-01 -0.564796
                2013-01-02 -0.333106
                2013-01-03 -2.814611
这是您对级别名称->片的描述
In [20]: slicers = { 'numbers' : slice(0,1), 'dates' : slice('20130102','20130103') }这将创建一个空索引器(选择所有内容)。
In [21]: indexer = [ slice(None) ] * len(df.index.levels)加入你的切片器
In [22]: for n, idx in slicers.items():
              indexer[df.index.names.index(n)] = idx
并选择(这必须是一个元组,但它是一个列表,因为我们必须修改它)
In [23]: df.loc[tuple(indexer),:]
Out[23]:
                                   0
numbers letters dates
0       a       2013-01-02 -1.267770
                2013-01-03  0.008230
        b       2013-01-02  0.351942
                2013-01-03 -0.245463
        c       2013-01-02 -0.385411
                2013-01-03 -1.740821
1       a       2013-01-02 -0.212350
                2013-01-03  0.021097
        b       2013-01-02 -1.769003
                2013-01-03 -0.594216
        c       2013-01-02  1.511700
2013-01-03 0.994332Stack Overflow用户
发布于 2022-04-03 12:23:25
为此,我使用了一个自定义函数。这个名称是sel,它受同名的xarray方法的启发。
def sel(df, /, **kwargs):
    """
    Select into a DataFrame by MultiIndex name and value

    This function is similar in functionality to pandas .xs() and even more similar (in interface) to xarray's .sel().

    Example:

    >>> index = pd.MultiIndex.from_product([['TX', 'FL', 'CA'],
    ...                                     ['North', 'South']],
    ...                                    names=['State', 'Direction'])
    >>> df = pd.DataFrame(index=index,
    ...                   data=np.random.randint(0, 10, (6,4)),
    ...                   columns=list('abcd'))
    >>> sel(df, State='TX')
                        a  b  c  d
       State Direction
       TX    North      5  5  9  5
             South      0  6  8  2
    >>> sel(df, State=['TX', 'FL'], Direction='South')
                        a  b  c  d
       State Direction
       TX    South      0  6  8  2
       FL    South      6  7  5  2

    indexing syntax is index_name=indexer where the indexer can be:

    - single index value
    - slice by using the slice() function
    - a list of index values
    - other indexing modes supported by indivdual axes in .loc[]

    Unnamed index levels can be selected using names _0, _1 etc where the number is the index level.

    raises KeyError if an invalid index level name is used.
    """
    # argument checking
    available_names = [name or f'_{i}' for i, name in enumerate(df.index.names)]
    extra_args = set(kwargs.keys()) - set(available_names)
    if extra_args:
        raise KeyError(f"Invalid keyword arguments, no index(es) {extra_args} in dataframe. Available indexes: {available_names}.")
    # compute indexers per index level
    index_sel = tuple(kwargs.get(name or f'_{i}', slice(None)) for i, name in enumerate(df.index.names))
    if not index_sel:
        index_sel = slice(None)
    # Fixup for single level indexes
    if len(df.index.names) == 1 and index_sel:
        index_sel = index_sel[0]
return df.loc[index_sel, :]Stack Overflow用户
发布于 2022-04-03 12:31:58
不幸的是,方法不支持常规切片,但它确实支持按名称和间隔在索引级别上进行选择!因此,它可以作为你问题的另一个答案。
查询通过使用backticks支持引用索引名,如下所示。
# Get an example dataset from seaborn
import pandas as pd
import seaborn as sns
df = sns.load_dataset("penguins")
df = df.rename_axis("numerical index / ħ")  # strange name to show escaping.
df = df.set_index(['species', 'island'], append=True)


# Working examples
# less than
df.query("`numerical index / ħ` < 100")

# range
slc = range(9, 90)
df.query("`numerical index / ħ` in @slc")

# Subsets
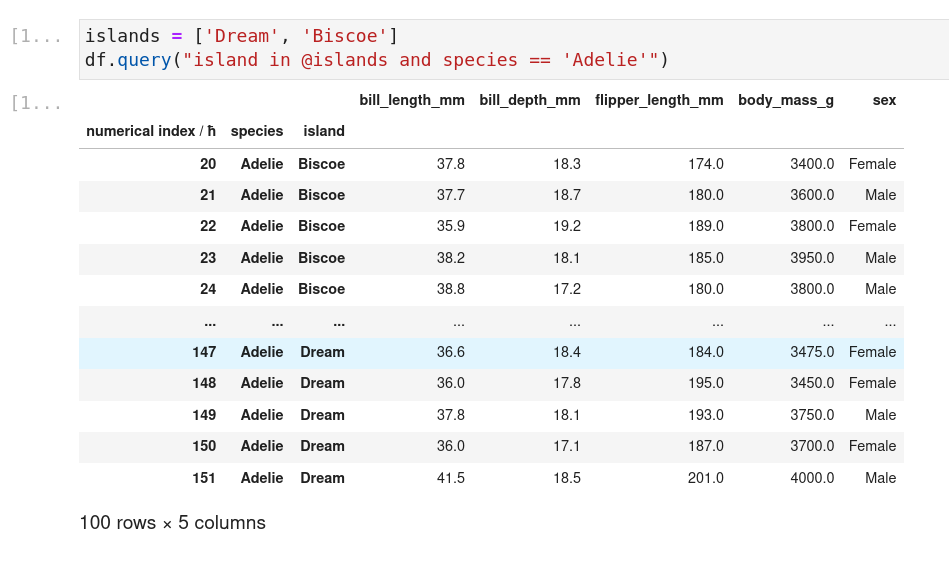
islands = ['Dream', 'Biscoe']
df.query("island in @islands and species == 'Adelie'")
https://stackoverflow.com/questions/24126542
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号