
一列中的SQL max值
我正在尝试获取在某一列("version")中具有最高值的记录。我使用base_id获取行,可能有多个行具有相同的base_id,但是它们将有不同的版本号。所以这句话的重点是只得到最高版本的那个。下面的语句起作用,但前提是实际存在一个以上的值。如果只有一个,那么我根本就没有记录(相对于预期的一行)。那么,即使对于某些记录,只有一个版本存在,我如何才能只得到以下最高版本号的值呢?
SELECT r.id
     , r.title
     , u.name created_by
     , m.name modified_by
     , r.version
     , r.version_displayname
     , r.informationtype
     , r.filetype
     , r.base_id
     , r.resource_id
     , r.created
     , r.modified
     , GROUP_CONCAT( CONCAT(CAST(c.id as CHAR),',',c.name,',',c.value) separator ';') categories
  FROM resource r
  JOIN category_resource cr
    ON r.id = cr.resource_id
  JOIN category c
    ON cr.category_id = c.id
  JOIN user u
    ON r.created_by = u.id
  JOIN user m
    ON r.modified_by = m.id
 WHERE r.base_id = 'uuid_033a7198-a213-11e3-93de-2b47e5a489c2'
   AND r.version = (SELECT MAX(r.version) FROM resource r)
 GROUP
    BY r.id;
编辑:
我意识到查询本身的其他部分可能会使事情复杂化,所以我将尝试创建一个更干净的示例,希望它能显示我所追求的目标。
如果我这么做:
SELECT id, title, MAX(version) AS 'version' FROM resource GROUP BY title在一张这样的桌子上:
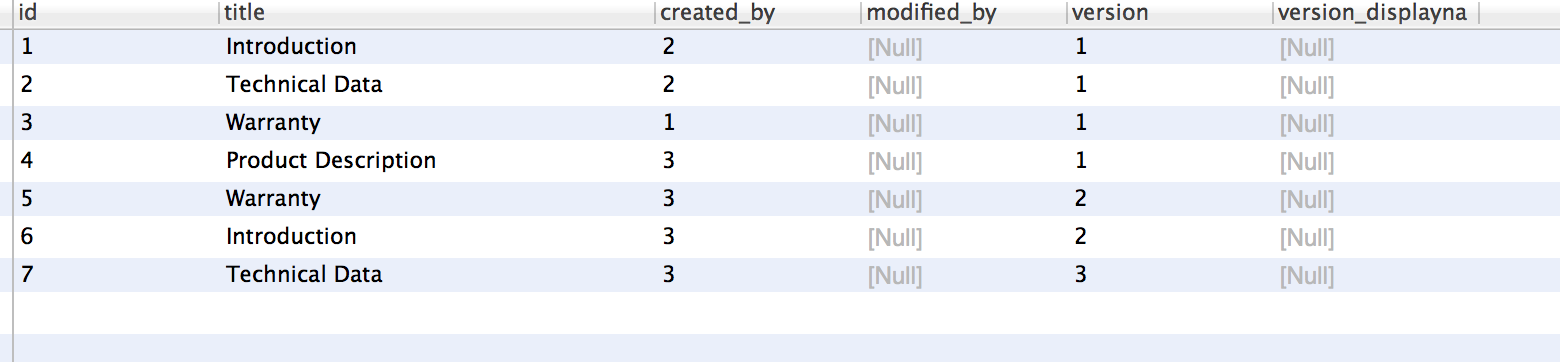
然后我得到以下结果:
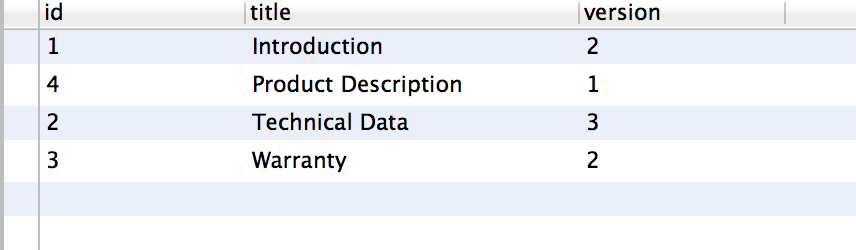
这是不正确的,你可以从桌子上看到。也就是说,它为每个资源获取最高值,但是如果您查看介绍,例如版本值为2的资源具有id 6,而获取的资源具有id 1。因此,查询似乎以某种方式将来自不同行的值组合在一起……?
我应该注意到,我在SQL方面是个新手,我所用的最初的查询就是我在这里得到的帮助,所以请尽可能清楚地解释,谢谢。
另一个注意事项是,我发现了一些关于子查询的建议,但是除了没有返回正确的结果之外,它真的很慢。我正在5000行上进行测试,为了满足性能要求,我确实需要期望它只需一小部分时间。
编辑2:
找到了一种合并语句的方法,类似于建议的语句之一,以及这里的各种解决方案:检索每个组中的最后一个记录
然而,我尝试了所有这些,尽管大多数看起来都有效,但是它们都非常慢,…。
拿这个:
SELECT
  r.id, r.title,
  u.name AS 'created_by', m.name AS 'modified_by', r.version, r.version_displayname, r.informationtype,
r.filetype, r.base_id, r.resource_id, r.created, r.modified,
  GROUP_CONCAT( CONCAT(CAST(c.id as CHAR),',',c.name,',',c.value) separator ';') AS 'Categories'
FROM
  resource r
  INNER JOIN
  (SELECT
   DISTINCT r.id AS id
  FROM
   resource r
  INNER JOIN
   category_resource cr1 ON (r.id = cr1.resource_id)
  WHERE
   cr1.category_id IN (9)
) mr

    ON r.id = mr.id
  INNER JOIN category_resource cr
    ON r.id = cr.resource_id
  INNER JOIN category c
    ON cr.category_id = c.id
  INNER JOIN user u
    ON r.created_by = u.id
  INNER JOIN user m
    ON r.modified_by = m.id
INNER JOIN
(
    SELECT max(version) MyVersion, base_id
    FROM resource
    GROUP BY base_id
) r2
  ON r.base_id = r2.base_id
  AND r.version = r2.MyVersion
group by r.base_id
order by r.version desc;
在末尾添加(从内部连接开始)只获得每个base_id的最高版本值的行,将查询从20 ms降低到6-8秒左右。这是一个拒绝的…但这让我吃惊。虽然我显然不是数据库专家,但在我看来,应该对数据库查询进行优化,以获得这样的数据。但是如果我做了我能想到的唯一的选择,那就是得到所有的记录,不管版本号如何,然后在PHP中过滤它们,你猜怎么着?这比这个…快得多
最初,我认为PHP过滤对性能造成的影响太大了,但这是大约一秒钟的延迟,所以仍然比这要好得多。
但我觉得我错过了什么,难道不应该更有效率吗?
回答 7
Stack Overflow用户
发布于 2014-03-05 21:38:45
我想我自己找到了答案。据我所知,这样的查询将花费大量的时间,而需要修改数据库。我发现了这个:
建议在最新版本中使用星型列和结束日期列,并将结束日期设置为null,这使得查询最新版本变得非常容易。而且它再次非常快。所以这就是我需要的。它给了我这样的东西,所有的组合在一起:
SELECT
  r.id, r.title,
  u.name AS 'created_by', m.name AS 'modified_by', r.version, r.version_displayname, r.informationtype,
r.filetype, r.base_id, r.resource_id, r.created, r.modified,
  GROUP_CONCAT( CONCAT(CAST(c.id as CHAR),',',c.name,',',c.value) separator ';') AS 'categories', startdate, enddate
FROM
  resource r
  INNER JOIN
  (SELECT
   DISTINCT r.id AS id
  FROM
   resource r
  INNER JOIN
   category_resource cr1 ON (r.id = cr1.resource_id)
  WHERE
   cr1.category_id IN (9)
) mr

    ON r.id = mr.id
  INNER JOIN category_resource cr
    ON r.id = cr.resource_id
  INNER JOIN category c
    ON cr.category_id = c.id
  INNER JOIN user u
    ON r.created_by = u.id
  INNER JOIN user m
    ON r.modified_by = m.id
WHERE r.enddate is null
group by r.id;
这个查询再次返回到20 ms的执行时间。
Stack Overflow用户
发布于 2014-03-11 18:07:07
给出你自己的答案,你的问题基本上和你提供的链接相同。既然你有一些小问题,我会给你一些额外的帮助。
如果您希望在数据库中有某种版本控制,那么您基本上可以通过某个版本列扩展您的主键。因为你提到的原因,我也会投票赞成使用startdate/enddate-列。给出您自己的答案,您可以相应地修改您的布局。如果可以的话,这就是你应该走的路!
在给定的示例中,不清楚主键是什么,因为'id‘列的值也在变化。在您的示例中,主键将是列“title”。所以您可以使用一些查询,例如
SELECT title, max(version) as version FROM resource GROUP BY title要获得一个结果,您可以看到原始主键和最新版本--它们共同构成了您的实际主键。
要获取该表中的所有其他字段,您可以将结果连接到资源表,并使用主键字段作为联接条件。
SELECT * FROM (
        SELECT title, max(version) as version
        FROM resource
        GROUP BY title) as s
    INNER JOIN resource r on (r.title = s.title AND r.version = s.version)
您的查询为什么给出错误的结果?
原因是,您在查询中出现了一个错误,即MySQL为您“修正了”。通常,您需要提供在GROUP BY子句中没有在聚合函数中使用的每一列(如MAX())。在你的例子中
SELECT id, title, MAX(version) AS 'version' FROM resource GROUP BY title查询的select部分中有一个colum ('id'),在GROUP BY子句中没有提供。
在(请看这里).中,可以忽略该规则--
在使用此功能时,每个组中的所有行对于按部分从组中删除的列都应该具有相同的值。服务器可以自由地从组返回任何值,因此除非所有值相同,否则结果是不确定的。
因为'id‘列对您的键( 'title’列)有不同的值,所以您刚刚得到了一些结果--在这种情况下,MySQL可能只是使用了它找到的第一行。但是结果本身是未定义的,并且可能会发生变化,例如,当数据库更新或数据增长时。您不应该依赖您从测试时看到的结果推断出的规则!
在其他数据库(如oracle和Server)上,执行最后一个查询时可能会出错。
我希望我能澄清一下你结果的原因。
Stack Overflow用户
发布于 2014-03-05 21:49:36
如果你尝试像这样的东西:-
SELECT r.id
     , r.title
     , u.name created_by
     , m.name modified_by
     , r.version
     , r.version_displayname
     , r.informationtype
     , r.filetype
     , r.base_id
     , r.resource_id
     , r.created
     , r.modified
     , GROUP_CONCAT( CONCAT(CAST(c.id as CHAR),',',c.name,',',c.value) separator ';') categories
  FROM resource r
  JOIN category_resource cr
    ON r.id = cr.resource_id
  JOIN category c
    ON cr.category_id = c.id
  JOIN user u
    ON r.created_by = u.id
  JOIN user m
    ON r.modified_by = m.id
 WHERE r.base_id = 'uuid_033a7198-a213-11e3-93de-2b47e5a489c2'
   AND r.version = (SELECT MAX(r1.version) FROM resource r1 where r1.base_id = r.base_id group by r.base_id)
 GROUP
BY r.id;https://stackoverflow.com/questions/22135526
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号