
如何将pdf表单字段自动导出到xml
我有一个包含表单字段的pdf文件,需要将数据自动导出到xml文件中。下面是我为测试而创建的示例表单的屏幕:
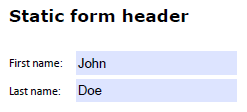
注意:通过单击Tools > Form > Export Form Data,使用Acrobat手动导出它非常有效,最后选择了输出。这是当我手动导出它时得到的结果:
<?xml version="1.0" encoding="UTF-8"?>
<fields>
    <first_name>John</first_name>
    <last_name>Doe</last_name>
</fields>但是,我需要自动化它,例如使用python脚本、Java实现或一些命令行工具。有哪些库或工具可以用于将表单字段数据导出到xml?工具或库应该是开放源码,这样我就可以将它集成到工作流中。
我已经尝试过python pdfminer库,它帮助我导出pdf文件的静态部分(如Static form header、First name:和Last name:):但是如何导出表单字段数据(在我的例子中是表单字段first_name和last_name的内容)?
编辑:欢迎下载sample.pdf文件这里。
回答 5
Stack Overflow用户
发布于 2014-01-23 21:00:02
Apache PDFBox怎么样?它是开源的,可以满足你的需要,因为网站上写着“从PDF表单中提取表单数据或预先填写PDF表单。”
编辑:查看PrintFields实例。
Stack Overflow用户
发布于 2014-01-22 20:02:46
在bash中,您可以这样做(至少可以使用我版本的这些工具,减去444和cat 8.13):
less ~/Downloads/sample.pdf | cat我得到的输出如下:
Static form header

First name:   John

Last name:    Doe
显然,您可以使用Java/Python/awk/什么来解析它。
当然,或者,如果您不想依赖这些版本的特定版本的行为(不确定它们是否总是这样做),您可以查找less的源代码来查看它是如何做到的。
Stack Overflow用户
发布于 2014-01-22 19:31:39
在Java中,有一些库可以使用PDF,但通常很难从PDF中获取格式化信息。我从来没有实现过那个东西,但是Qoppa看起来很好,看起来很先进,但它不是免费的。它包含jPDFFields,对于从表单字段提取值应该很有用。还有一个相似螺纹,其中包含一些关于命令行工具的信息。
我希望这对你有帮助。
https://stackoverflow.com/questions/21009608
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号