
Server创建索引而不是索引
只是想知道当我们创建SQL Server时内部会发生什么,
- 非聚集在聚集索引之上。
- 聚集索引优于非聚集索引。
- 非聚集索引大于非聚集索引。
请发表意见。
回答 1
Stack Overflow用户
发布于 2013-12-30 13:40:30
对于所有的执行计划,我使用了相同的基表,其中填充了毫无意义的数据:
CREATE TABLE dbo.T (ID INT NOT NULL, Filler CHAR(200) NULL);
INSERT dbo.T (ID, Filler)
SELECT  ROW_NUMBER() OVER(ORDER BY Object_ID),
        CAST(NULLIF(ABS(Object_ID) % 10, 0) AS CHAR(200))
FROM    sys.all_objects
1.当我们在聚集索引上创建非群集时,Server内部会发生什么。
这只是一个正常的创建索引过程,因此对指定的庄园中的数据进行排序,并从叶节点上创建相关节点。叶节点将存储一个指向聚集索引的“指针”,以便进行键查找。
因此,在dbo.T (ID)上设置聚集索引之后,创建非聚集索引的执行计划显示了排序:
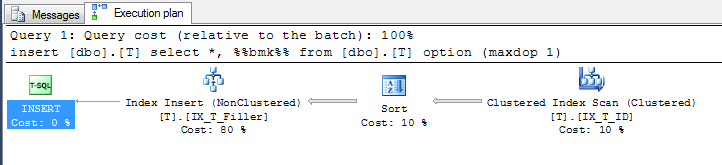
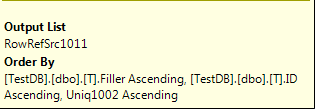
在排序上徘徊显示它是按Filler排序的,然后添加它自己的排序以确保排序是确定性的:
2.当我们在非聚集索引之上创建聚集索引时,Server内部会发生什么。
为了正确地解释这一点,我需要解释一下没有聚集索引的表上的聚集索引是如何工作的。没有聚集索引的表称为“堆”表,这意味着数据不按特定顺序存储,通常只是按插入的顺序存储。本质上,Server在内部列rowID上构建自己的聚集索引,但是没有显式聚集索引的约束,它可以自由地移动数据,如果它认为合适(http://www.sqlskills.com/blogs/paul/forwarding-and-forwarded-records-and-the-back-pointer-size/),那么非聚集索引将在叶级存储RowID,这样它就可以执行查找。
然后,当您在堆表上创建聚集索引时,必须重新构建表,并按您指定的列排序,这意味着所有索引也将被删除和重建。为了显示这一点,我首先向dbo.T添加了非聚集索引
CREATE NONCLUSTERED INDEX IX_T_Filler ON dbo.T (Filler);
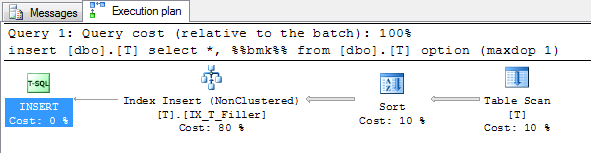
与上面不同,您可以看到表扫描是在没有可使用的聚集索引的情况下完成的,而创建索引时所做的排序不像上面那样包括ID列:
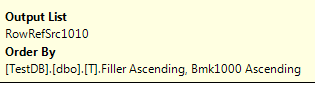
然后添加聚集索引:
CREATE CLUSTERED INDEX IX_T_ID ON dbo.T (ID);您可以在执行计划中看到,非聚集索引也被重建,因此叶将指向新的聚集索引,而不是像以前那样指向行ID。(注意,第二个查询与第一部分中建立在聚集索引上的非聚集索引相同)
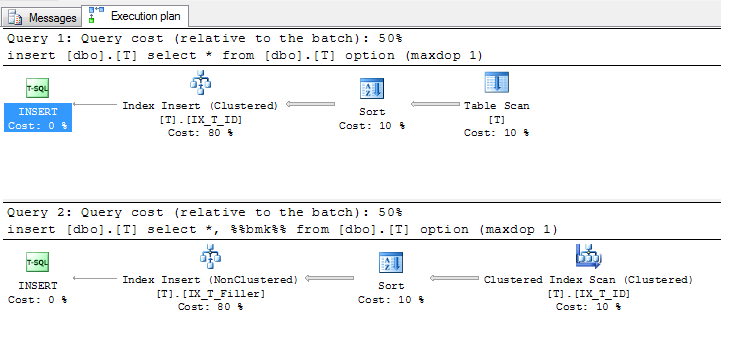
3.当我们在非聚集索引之上创建非聚集索引时,Server内部会发生什么。
非聚集索引彼此完全独立,因此这与1相同(如果没有聚集键,则为2的第一部分),也就是说,不管已经存在多少非聚集索引,创建新索引的方法都是相同的。
https://stackoverflow.com/questions/20839777
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号