
在Hive中划分和存储表有什么区别?
我知道这两个操作都是在表中的一个列上执行的,但是每个操作有什么不同。
回答 8
Stack Overflow用户
发布于 2013-10-02 06:37:05
分区数据通常用于水平分布负载,这具有性能优势,有助于以逻辑方式组织数据。示例:如果我们处理的是一个大型的employee表,并且经常使用WHERE子句运行查询,这些子句将结果限制在特定的国家或部门。为了获得更快的查询响应,Hive表可以是PARTITIONED BY (country STRING, DEPT STRING)。分区表改变了Hive构造数据存储的方式,Hive现在将创建反映分区结构的子目录,如
./雇员/国家=ABC/DEPT=XYZ。
如果来自country=ABC的employee的查询限制,它将只扫描一个目录country=ABC的内容。这可以极大地提高查询性能,但前提是分区方案反映了常见的筛选。分区特性在Hive中非常有用,但是,创建太多分区的设计可能会优化某些查询,但会对其他重要查询产生不利影响。另一个缺点是分区太多,大量的Hadoop文件和目录被不必要地创建,并且给NameNode带来了开销,因为它必须将文件系统的所有元数据都保存在内存中。
存储是另一种将数据集分解为更易于管理的部分的技术。例如,假设一个使用date作为顶层分区,employee_id作为第二级分区的表会导致太多的小分区。相反,如果我们对employee表进行存储,并使用employee_id作为存储列,则该列的值将由用户定义的数字散列为桶。具有相同employee_id的记录将始终存储在同一个桶中。假设employee_id的数量远远大于桶的数量,那么每个桶都会有许多employee_id。在创建表时,可以指定类似于CLUSTERED BY (employee_id) INTO XX BUCKETS;,其中XX是存储桶的数量。水桶有几个优点。桶的数量是固定的,所以它不会随数据波动。如果两个表由employee_id存储,Hive可以创建一个逻辑正确的抽样。水桶也有助于做有效的地图边连接等。
Stack Overflow用户
发布于 2015-12-06 23:42:09
在前面的解释中缺少了一些细节。要更好地理解分区和分块是如何工作的,您应该查看数据是如何存储在单元中的。假设你有一张桌子
CREATE TABLE mytable (
         name string,
         city string,
         employee_id int )
PARTITIONED BY (year STRING, month STRING, day STRING)
CLUSTERED BY (employee_id) INTO 256 BUCKETS
然后,hive将将数据存储在目录层次结构中,如
/user/hive/warehouse/mytable/y=2015/m=12/d=02因此,在分区时必须小心,因为例如,如果您使用employee_id进行分区,并且您有数百万名员工,那么您的文件系统中将有数百万个目录。术语'cardinality‘指的是字段可能具有的值的数量。例如,如果你有一个“国家”领域,世界上的国家大约有300个,所以基数是300。对于‘时间戳_ms’这样的字段,它每毫秒都会发生变化,基数可能是数十亿。通常,当选择要分区的字段时,它不应该具有很高的基数,因为最终文件系统中的目录太多了。
另一方面,集群(又名阻塞)将产生固定数量的文件,因为您确实指定了存储桶的数量。hive将做的是获取该字段,计算一个散列,并将一条记录分配给该桶。但是,如果您使用256个桶,而您所使用的字段具有较低的基数(例如,它是一个美国状态,所以只能有50个不同的值),那么会发生什么呢?您将有50个有数据的桶,206个没有数据的桶。
有人已经提到了分区如何可以显着地减少您正在查询的数据量。因此,在我的示例表中,如果您只想从某个日期向前查询,按年/月/日进行分区将大大减少IO的数量。我想有人还提到了如何加快与具有完全相同存储方式的其他表的连接速度,因此在我的示例中,如果您在同一个employee_id上连接两个表,则hive可以逐桶连接(如果它们已经按照employee_id排序,因为它们将合并已经排序的部分,这在线性时间(又名O(n) )中工作)更好。
因此,当字段具有较高的基数且数据在桶中均匀分布时,斗式工作良好。当分区字段的基数不太高时,分区效果最好。
此外,您还可以在多个字段上进行分区,使用订单(年份/月/日是一个很好的例子),而只能在一个字段上存储。
Stack Overflow用户
发布于 2019-04-07 00:20:49
在进入Bucketing之前,我们需要了解Partitioning是什么。让我们以下表为例。请注意,在下面的例子中,我只提供了12条记录供初学者理解。在实时场景中,你可能有数百万的记录。
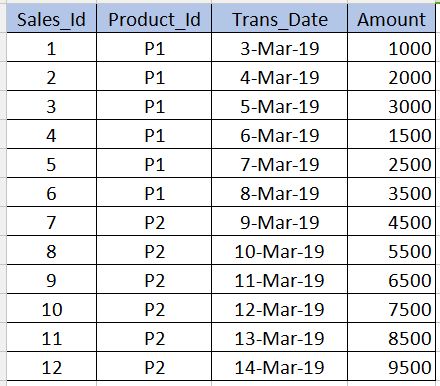
分区
---------------------
Partitioning用于在查询数据时获得性能。例如,在上面的表中,如果我们编写下面的sql,它需要扫描表中的所有记录,从而降低性能并增加开销。
select * from sales_table where product_id='P1'为了避免全表扫描,并且只读取与product_id='P1'相关的记录,我们可以根据product_id列将(拆分蜂窝表的文件)划分为多个文件。这样,hive表的文件将被分成两个文件,一个是product_id='P1'文件,另一个是product_id='P2'文件。现在,当我们执行上面的查询时,它将只扫描product_id='P1'文件。
../hive/warehouse/sales_table/product_id=P1
../hive/warehouse/sales_table/product_id=P2下面给出了创建分区的语法。注意,我们不应该在下面的语法中使用product_id列定义和非分区列。这应该只出现在partitioned by子句中。
create table sales_table(sales_id int,trans_date date, amount int)
partitioned by (product_id varchar(10))Cons:我们在分区时应该非常小心。也就是说,它不应该用于重复值数量非常少的列(特别是主键列),因为它增加了分区文件的数量并增加了Name node的开销。
水桶式
------------------
Bucketing用于克服我在分区部分中提到的cons。当列中的重复值很少(例如-主键列)时,应使用此方法。这类似于RDBMS中主键列上索引的概念。在我们的表中,我们可以使用Sales_Id列作为桶。当我们需要查询sales_id列时,它将非常有用。
下面是桶的语法。
create table sales_table(sales_id int,trans_date date, amount int)
partitioned by (product_id varchar(10)) Clustered by(Sales_Id) into 3 buckets
在这里,我们将进一步将数据分割为分区之上的更多文件。
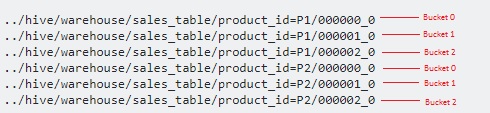
因为我们已经指定了3桶,所以每个product_id将每个桶分成3个文件。它在内部使用modulo operator来确定每个sales_id应该存储在哪个桶中。例如,对于product_id='P1',sales_id=1将存储在000001_文件(即1%3=1)中,sales_id=2将存储在000002_文件(即2%3=2)中,sales_id=3将存储在000000_E 244文件(例如,3%3=0)中,等等。
https://stackoverflow.com/questions/19128940
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号