
关于ID3机器学习算法中统计熵概念的几个疑问
我正在研究统计熵概念,这是ID3机器学习算法所使用的。
对于以学习集S为例的域(即用于构建决策树的示例集),熵方法给出了对对象分类所需的平均信息量。
因此,我有以下公式:
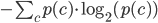
因此,例如:
,如果S是一个由14个例子组成的集合,其中有9个是,5个没有,那么我有一个例子:
熵(S)=- (9/14)*Log2(9/14) - (5/14)*Log2(5/14) = 0.940
这算起来很简单,我的问题是,在我的书上,我也读到了这张便条:
注意,如果S的所有成员都属于同一类(数据是完全分类的),则熵为0。熵的范围是0(“完全分类”)到1(“完全随机”)。
这个断言使我感到困惑,因为我试图以这样的方式更改前面的示例:
,如果S是14个示例的集合,其中有14个是和0没有例子,那么我有:
熵(S)=- (14/14)*Log2(14/14) -(0/14)*Log2 2(0/14)=0-无穷大
因此,在本例中,所有对象都属于同一个类(是),没有示例属于no类。
因此,我期望这个S集的熵值是0,没有-无穷大。
我遗漏了什么?
Tnx
安德里亚
回答 1
Stack Overflow用户
发布于 2013-06-21 07:03:08
在计算熵时,可以通过迭代所涉节点上的唯一分类值来进行求和。您可以在每次迭代中通过计算集合中有多少成员具有该值,然后使用日志公式来完成此操作。在您的问题案例中,唯一出现的分类值是“是”,这意味着基于单个迭代,熵为零。不能在NO值上迭代,因为所有示例都没有该值。
https://stackoverflow.com/questions/17147183
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号