
SQL性能:选择DISTINCT和GROUP
我一直试图提高一个运行缓慢的现有Oracle数据库驱动应用程序的查询时间。应用程序执行几个大型查询,如下面的查询,运行时间超过一个小时。在下面的查询中用GROUP BY子句替换GROUP BY将执行时间从100分钟缩短到10秒。我的理解是,SELECT DISTINCT和GROUP BY的运作方式基本相同。为什么执行时间之间存在如此巨大的差距?在后端执行查询的方式有什么不同?有过SELECT DISTINCT运行速度更快的情况吗?
注意:在下面的查询中,WHERE TASK_INVENTORY_STEP.STEP_TYPE = 'TYPE A'只是可以过滤结果的许多方法之一。提供此示例是为了说明将所有未包含在SELECT中的列的表连接起来的理由,这些表将导致大约十分之一的可用数据。
使用DISTINCT的SQL:
SELECT DISTINCT
    ITEMS.ITEM_ID,
    ITEMS.ITEM_CODE,
    ITEMS.ITEMTYPE,
    ITEM_TRANSACTIONS.STATUS,
    (SELECT COUNT(PKID)
        FROM ITEM_PARENTS
        WHERE PARENT_ITEM_ID = ITEMS.ITEM_ID
        ) AS CHILD_COUNT
FROM
    ITEMS
    INNER JOIN ITEM_TRANSACTIONS
        ON ITEMS.ITEM_ID = ITEM_TRANSACTIONS.ITEM_ID
        AND ITEM_TRANSACTIONS.FLAG = 1
    LEFT OUTER JOIN ITEM_METADATA
        ON ITEMS.ITEM_ID = ITEM_METADATA.ITEM_ID
    LEFT OUTER JOIN JOB_INVENTORY
        ON ITEMS.ITEM_ID = JOB_INVENTORY.ITEM_ID
    LEFT OUTER JOIN JOB_TASK_INVENTORY
        ON JOB_INVENTORY.JOB_ITEM_ID = JOB_TASK_INVENTORY.JOB_ITEM_ID
    LEFT OUTER JOIN JOB_TASKS
        ON JOB_TASK_INVENTORY.TASKID = JOB_TASKS.TASKID
    LEFT OUTER JOIN JOBS
        ON JOB_TASKS.JOB_ID = JOBS.JOB_ID
    LEFT OUTER JOIN TASK_INVENTORY_STEP
        ON JOB_INVENTORY.JOB_ITEM_ID = TASK_INVENTORY_STEP.JOB_ITEM_ID
    LEFT OUTER JOIN TASK_STEP_INFORMATION
        ON TASK_INVENTORY_STEP.JOB_ITEM_ID = TASK_STEP_INFORMATION.JOB_ITEM_ID
WHERE
    TASK_INVENTORY_STEP.STEP_TYPE = 'TYPE A'
ORDER BY
ITEMS.ITEM_CODE使用GROUP BY的SQL:
SELECT
    ITEMS.ITEM_ID,
    ITEMS.ITEM_CODE,
    ITEMS.ITEMTYPE,
    ITEM_TRANSACTIONS.STATUS,
    (SELECT COUNT(PKID)
        FROM ITEM_PARENTS
        WHERE PARENT_ITEM_ID = ITEMS.ITEM_ID
        ) AS CHILD_COUNT
FROM
    ITEMS
    INNER JOIN ITEM_TRANSACTIONS
        ON ITEMS.ITEM_ID = ITEM_TRANSACTIONS.ITEM_ID
        AND ITEM_TRANSACTIONS.FLAG = 1
    LEFT OUTER JOIN ITEM_METADATA
        ON ITEMS.ITEM_ID = ITEM_METADATA.ITEM_ID
    LEFT OUTER JOIN JOB_INVENTORY
        ON ITEMS.ITEM_ID = JOB_INVENTORY.ITEM_ID
    LEFT OUTER JOIN JOB_TASK_INVENTORY
        ON JOB_INVENTORY.JOB_ITEM_ID = JOB_TASK_INVENTORY.JOB_ITEM_ID
    LEFT OUTER JOIN JOB_TASKS
        ON JOB_TASK_INVENTORY.TASKID = JOB_TASKS.TASKID
    LEFT OUTER JOIN JOBS
        ON JOB_TASKS.JOB_ID = JOBS.JOB_ID
    LEFT OUTER JOIN TASK_INVENTORY_STEP
        ON JOB_INVENTORY.JOB_ITEM_ID = TASK_INVENTORY_STEP.JOB_ITEM_ID
    LEFT OUTER JOIN TASK_STEP_INFORMATION
        ON TASK_INVENTORY_STEP.JOB_ITEM_ID = TASK_STEP_INFORMATION.JOB_ITEM_ID
WHERE
    TASK_INVENTORY_STEP.STEP_TYPE = 'TYPE A'
GROUP BY
    ITEMS.ITEM_ID,
    ITEMS.ITEM_CODE,
    ITEMS.ITEMTYPE,
    ITEM_TRANSACTIONS.STATUS
ORDER BY
ITEMS.ITEM_CODE下面是使用DISTINCT的查询的Oracle查询计划
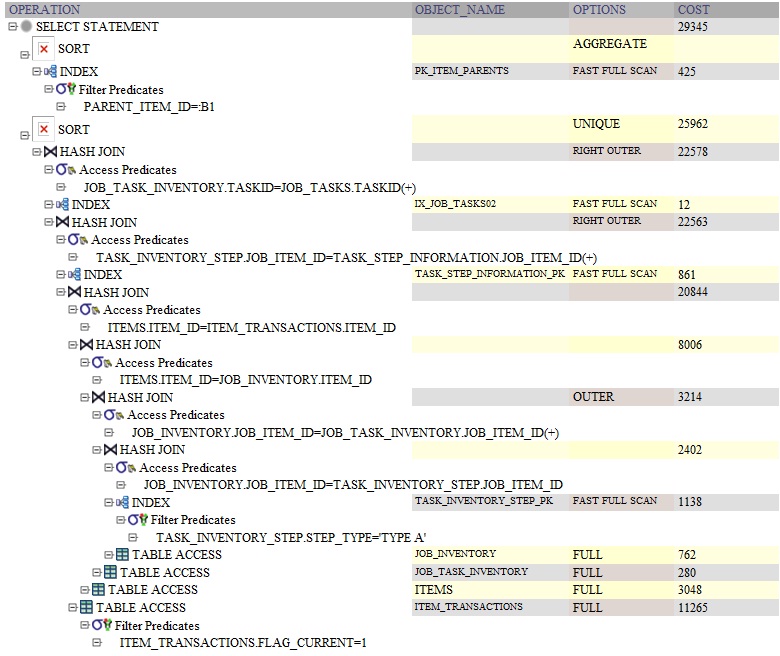
下面是使用GROUP BY的查询的Oracle查询计划
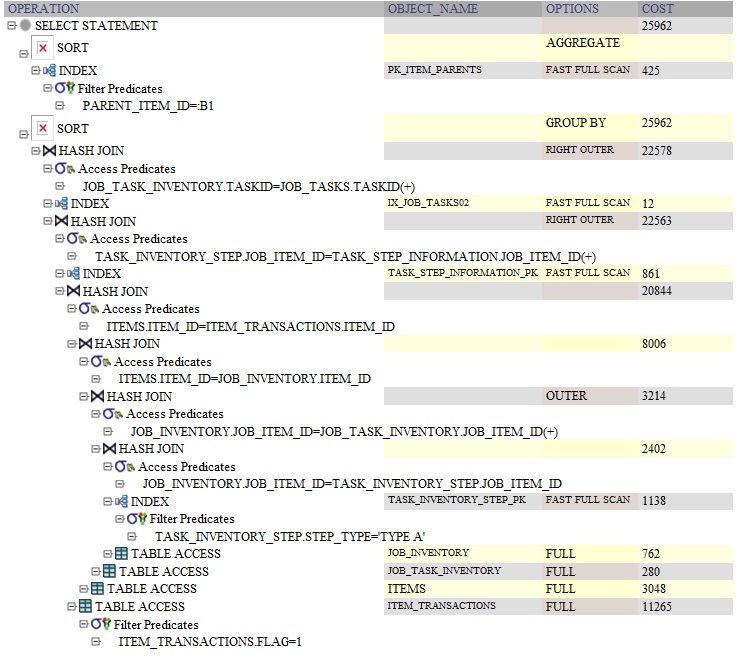
回答 4
Stack Overflow用户
发布于 2012-12-19 16:39:52
性能差异可能是由于执行了SELECT子句中的子查询。我猜它是在对每个不同的行重新执行这个查询。对于group by,它将在组by之后执行一次。
尝试用一个join替换它,而不是:
select . . .,
       parentcnt
from . . . left outer join
      (SELECT PARENT_ITEM_ID, COUNT(PKID) as parentcnt
       FROM ITEM_PARENTS
      ) p
on items.item_id = p.parent_item_idStack Overflow用户
发布于 2012-12-19 16:38:36
我相当肯定GROUP BY和DISTINCT有大致相同的执行计划。
由于我们必须猜测(因为我们没有解释计划),这里的区别是内联子查询是在 GROUP BY之后执行的,而是在 DISTINCT之前执行的。
因此,如果查询返回100万行并被聚合为1k行:
GROUP BY查询将运行子查询1000次,- 而
DISTINCT查询将运行子查询1000000次。
tkprof解释计划将有助于证明这一假设。
在我们讨论这个问题时,我认为重要的是要注意,写查询的方式对读者和优化器都是误导的:显然,您希望从item/item_transactions中找到具有值为“A”的TASK_INVENTORY_STEP.STEP_TYPE的所有行。
海事组织,您的查询将有更好的计划,如果这样写的话,您的查询将更容易阅读:
SELECT ITEMS.ITEM_ID,
       ITEMS.ITEM_CODE,
       ITEMS.ITEMTYPE,
       ITEM_TRANSACTIONS.STATUS,
       (SELECT COUNT(PKID)
          FROM ITEM_PARENTS
         WHERE PARENT_ITEM_ID = ITEMS.ITEM_ID) AS CHILD_COUNT
  FROM ITEMS
  JOIN ITEM_TRANSACTIONS
    ON ITEMS.ITEM_ID = ITEM_TRANSACTIONS.ITEM_ID
   AND ITEM_TRANSACTIONS.FLAG = 1
 WHERE EXISTS (SELECT NULL
                 FROM JOB_INVENTORY
                 JOIN TASK_INVENTORY_STEP
                   ON JOB_INVENTORY.JOB_ITEM_ID=TASK_INVENTORY_STEP.JOB_ITEM_ID
                WHERE TASK_INVENTORY_STEP.STEP_TYPE = 'TYPE A'
                  AND ITEMS.ITEM_ID = JOB_INVENTORY.ITEM_ID)
在许多情况下,DISTINCT可以表示查询写得不正确(因为一个好的查询不应该返回重复的查询)。
还请注意,在原始选择中没有使用4个表。
Stack Overflow用户
发布于 2012-12-19 16:40:24
应该注意的第一件事是使用Distinct表示代码气味,也就是反模式。它通常意味着缺少一个连接或一个额外的连接,生成重复的数据。查看上面的查询,我猜想group by更快的原因(没有看到查询)是因为group by的位置减少了最终返回的记录数量。而distinct却在吹熄结果集并逐行进行比较。
更新以接近
抱歉,我应该说清楚的。当用户在系统中执行某些任务时会生成记录,因此没有计划。用户可以在一天内生成一条记录,或者每小时生成数百条记录。重要的是,每次用户运行搜索时,都必须返回最新的记录,这让我怀疑物化视图是否能在这里工作,特别是如果填充它的查询需要很长时间才能运行。
我相信这正是使用物化视图的确切原因。所以这个过程会是这样的。您可以将长时间运行的查询作为构建物化视图的部分,因为我们知道用户只在系统中执行一些任意任务之后才关心“新”数据。因此,您想要做的是对这个基本物化视图进行查询,这个视图可以在后端不断刷新,所涉及的持久性策略不应该扼杀物化视图(一次保存几百条记录不会破坏任何东西)。这将允许Oracle获取一个读锁(请注意,我们不在乎有多少源读取我们的数据,我们只关心作者)。在最坏的情况下,用户将拥有微秒的“陈腐”数据,因此,除非这是华尔街的金融交易系统或核反应堆系统,否则即使是目光最敏锐的用户也不应该注意到这些“亮点”。
如何这样做的代码示例:
create materialized view dept_mv FOR UPDATE as select * from dept; 现在,关键是只要不调用refresh,就不会丢失任何持久化数据。这将由你来决定什么时候你想再次“基线”你的物化视图(也许午夜?)
https://stackoverflow.com/questions/13956768
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号