
版本化数据的数据模型设计
我正在寻找一些关于设计围绕版本化数据的数据模型的最佳方法的输入。会有一对多和多对多的关系,这些关系都可以在不同版本之间发生变化。
我正在寻找一些不同的策略,最终目标是高效的比较,如果可能的话,只存储增量。
回答 1
Stack Overflow用户
发布于 2012-10-19 20:19:12
简介
这其实是一个相当困难的问题。
对对象进行版本控制很容易。版本控制它们之间的连接--您将不得不做出一些设计决策。例如:
- 你需要在历史上的任何时刻得到整个图的“快照”吗?
- 您希望永久删除还是恢复已删除的对象和连接?
- 你更喜欢速度(而且不介意在不同版本之间复制整个图形)还是空间?
最重要的是,大多数“支持”表可能也需要“版本感知”。
设计
如果我是你,我可能会从以下起点开始工作:
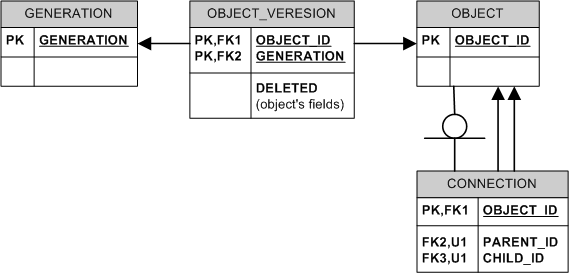
对象和连接之间的符号是https://stackoverflow.com/a/12037398/533120 (又名。继承、子类、泛化层次结构等)。
此设计的基本思想是支持“快照”、“还原”和“增量”功能:
- 整个图有一个全局版本(又名。(“世代”)而我们只在它们之间储存三角洲。
- 每个对象都有全局生成版本(而不是本地的、特定于对象的版本)。
- 连接是对象,这使得它们也具有版本化。
- 每当一组对象进入存储库时,都会插入新一代和:。
- 插入的对象被插入到对象和OBJECT_VERSION中。
- 修改后的对象被插入到OBJECT_VERSION中。
- 一个已删除的对象被插入到OBJECT_VERSION中,其中包含deleted = true。
- 将还原的对象插入到OBJECT_VERSION中,其中删除= false。顺便说一句,这使得删除/还原循环可以重复多次。
- 其余的对象都是未接触的,因此我们不会浪费空间复制周围未更改的数据。
- 连接不能真正被修改。若要将子对象“移动”到新父节点,请删除旧连接(如上面所述设置“删除”)并插入新连接。事实上,删除是连接支持的唯一一种修改。
查询应该是这样的:
- 要从其所有版本中获取单个对象,请选择仍然不高于所需生成的最高对象。如果此版本的删除为真,则此代中不存在对象。
- 若要在所需的生成时获得整个图的快照,请对所有对象执行上述操作并创建内存中的图。删除一个或两个端点被删除的连接。
- 要使对象连接到给定的对象,递归遍历连接,但一旦遇到不符合上述条件的对象,则立即切断递归。
示例
假设您必须放置对象A、B和C,其中A是B和C的父对象:
generation: 0

      A0
     /  \
   B0    C0
添加新的对象D:
generation: 0 1

      A0
     / | \
   B0  C0 D1
修改A和C并删除B:
generation: 0 1 2

      A0
      A2
     / | \
   B0  C0 D1
   B2* C2

   (*) OBJECT_VERSION.DELETED is true
将C从A移动到D:
generation: 0 1 2 3

      A0
      A2
     / |* \
   B0  C0  D1
   B2* C2  |
           C3
等等..。
一些思考
此设计容易出现不一致删除的异常情况:数据库不会保护自己不连接已删除和未删除的对象,也不会在不删除连接的情况下将其中一个对象演化为已删除的状态。在检查两个端点之前,您将不知道连接是否有效。如果您的数据是分层的,则可以使用“可达性模型”:如果可以从某个根对象到达对象,则不会删除对象。您从不直接删除对象--只需删除与它的所有连接即可。对于文件夹/文件或类似的层次结构,这可以很好地工作,从“顶部”开始,然后向底部搜索,直到到达所需的对象为止。
替代“不可变”连接的方法是从CONNECTION_VERSION继承OBJECT_VERSION并将父ID/子ID放在那里,使用标识关系来确保diamond-shaped dependency is correctly modeled。如果您需要跟踪移动的历史,这可能是有用的。
当然,这只是泛泛而谈,我希望你能找到自己的路.
https://stackoverflow.com/questions/12979778
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号