
屏幕截图中低分辨率文本的OCR
我正在编写一个OCR应用程序来读取截图图像中的字符。目前,我只关注数字。我的方法部分是基于以下博客文章:http://blog.damiles.com/2008/11/basic-ocr-in-opencv/。
我可以成功地提取每个人的字符使用一些聪明的阈值。事情变得有点棘手的地方是匹配字符。即使有固定的字体面和大小,也有一些变量,如背景颜色和角化,会导致相同的数字以稍微不同的形状出现。例如,下面的图像被分割成三个部分:
- 顶部:从屏幕截图中成功提取的目标数字。
- 中间:模板:来自我训练集的一个数字。
- 底部:顶部和中间图像之间的误差(绝对差)。
所有部件都已被缩放(两条绿色水平线之间的距离表示一个像素)。
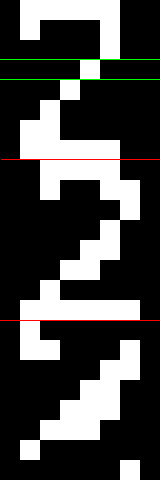
您可以看到,尽管顶部和中间的图像都清楚地表示为2,但它们之间的误差还是相当高的。当匹配其他数字时,这会导致误报--例如,不难看出一个位置良好的7能比中间图像更好地匹配上面图像中的目标数字。
目前,我正在处理这个问题,方法是为每个数字设置一堆训练图像,并将目标数字与这些图像进行一对一的匹配。我试着获取训练集的平均图像,但这并不能解决问题(其他数字上的假阳性)。
我有点不愿意使用移位模板执行匹配(这与我现在所做的基本相同)。是否有比简单的绝对差异更好的方法来比较这两幅图像?我当时想的可能是2D中的EMD (地球移动距离,搬运机's_distance):基本上,我需要一种对全局移动和小局部变化不那么敏感的比较方法(白色像素旁边的像素变成白色,或者黑色像素旁边的像素变成黑色),但对全局变化很敏感(黑色像素不接近白色像素变成黑色,反之亦然)。
有人能提出比绝对差更有效的匹配方法吗?
我正在使用C风格的Python (import cv)在OpenCV中完成所有这些工作。
回答 3
Stack Overflow用户
发布于 2012-01-02 04:17:00
我会研究使用Haar级联。我已经把它们用于人脸检测/头部跟踪,看起来你可以用足够的'2's,'3's,'4's建立一套很好的级联。
Stack Overflow用户
发布于 2012-01-02 07:33:54
在含噪图像上使用OCR并不容易--所以简单的方法不能很好地工作。
因此,我建议您使用猪来提取特征,使用支持向量机进行分类。猪似乎是描述形状最有力的方法之一。
整个处理管道都是用OpenCV实现的,但是我不知道python中的函数名。你应该能够和最新的haartraining.cpp一起训练--它实际上支持的不仅仅是haar - HOG和LBP。
我认为最新的代码(从主干)比官方版本(2.3.1)有了很大的改进。
HOG通常只需要其他识别方法所使用的培训数据的一小部分,但是,如果您想要对部分已包括(或缺失)的形状进行分类,则应确保在培训中包括一些此类形状。
Stack Overflow用户
发布于 2012-05-22 18:05:15
我可以从我的经验和阅读几篇关于字符分类的文章中告诉你,一个好的开始方法是阅读主成分分析(PCA)、Fisher的线性鉴别分析(LDA)和支持向量机(SVMs)。这些分类方法对于OCR非常有用,而且事实证明,OpenCV已经包括了PCAs和支持向量机上的优秀实现。我还没有看到OCR的任何OpenCV代码示例,但是您可以使用一些修改过的面部分类版本来执行字符分类。用于OpenCV的人脸识别代码的一个优秀资源是本网站。
我推荐您的另一个Python库是"scikits.learn“。很容易将cvArrays发送到scikits.learn,并在数据上运行机器学习算法。支持向量机用于OCR的一个基本例子是这里。
另一个更复杂的例子使用多种学习的手写字符识别是这里。
https://stackoverflow.com/questions/8697303
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号