
理解“随机性”
我无法理解这件事,哪一个更随意?
rand()或
rand() * rand()我发现这是一个真正的脑筋挑逗,你能帮我一下吗?
编辑:
直觉上,我知道数学上的答案是,它们都是随机的,但我不禁要想,如果你“运行随机数算法”两次,当你将两者相乘时,你会创造出比一次更随机的东西。
回答 27
Stack Overflow用户
发布于 2010-10-18 04:03:16
只是澄清一下
尽管当您试图发现伪随机变量或其乘法的随机性时,前面的答案是正确的,但是您应该注意到,虽然随机()通常是均匀分布的,但是随机()*随机()不是。
示例
这是一个通过伪随机变量模拟的均匀随机分布样本:
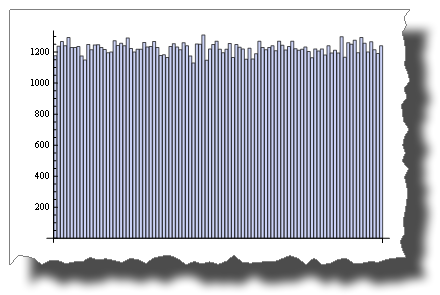
BarChart[BinCounts[RandomReal[{0, 1}, 50000], 0.01]]虽然这是在乘以两个随机变量之后得到的分布:
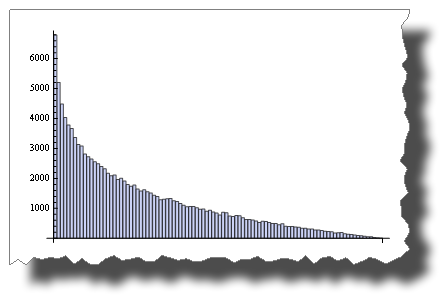
        BarChart[BinCounts[Table[RandomReal[{0, 1}, 50000] *
                                 RandomReal[{0, 1}, 50000], {50000}], 0.01]]
因此,两者都是“随机”的,但它们的分布是非常不同的。
另一个例子
而2 *随机()是一致分布的:
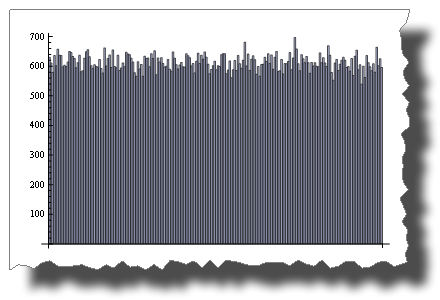
BarChart[BinCounts[2 * RandomReal[{0, 1}, 50000], 0.01]]随机()+随机()不是!
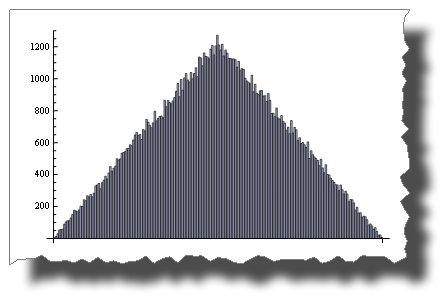
        BarChart[BinCounts[Table[RandomReal[{0, 1}, 50000] +
                                 RandomReal[{0, 1}, 50000], {50000}], 0.01]]
中心极限定理
中心极限定理 指出,随着术语的增加,()的和趋于 正态分布 E 127。
只有四个条件你可以得到:
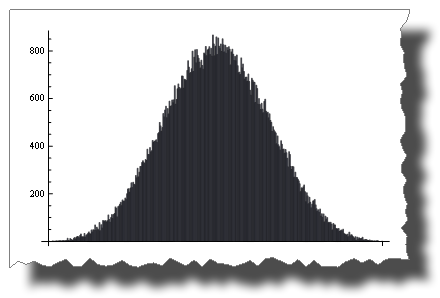
BarChart[BinCounts[Table[RandomReal[{0, 1}, 50000] + RandomReal[{0, 1}, 50000] +
                   Table[RandomReal[{0, 1}, 50000] + RandomReal[{0, 1}, 50000],
                   {50000}],
         0.01]]
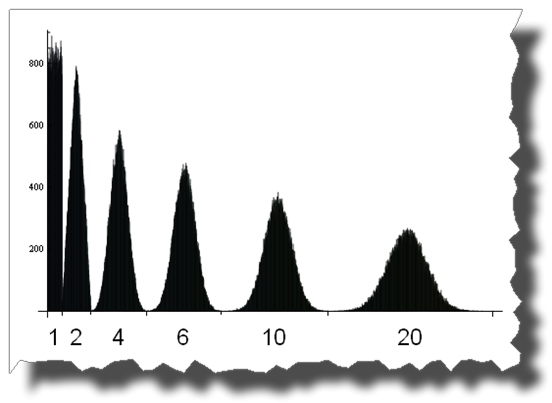
在这里,通过将1、2、4、6、10和20个均匀分布的随机变量相加,可以看到从均匀分布到正态分布的道路:
编辑
几个学分
感谢托马斯·阿勒在注释中指出,最后两幅图像中显示的概率分布称为Irwin-Hall分布
Stack Overflow用户
发布于 2010-10-18 20:32:29
我想这两种方法都是随机的,尽管我的直觉会说rand() * rand()不那么随机,因为它会产生更多的零。一旦一个rand()是0,总数就变成0
Stack Overflow用户
发布于 2010-10-18 03:45:19
也不是“更随意”。
rand()基于psuedo随机种子生成一组可预测的数字(通常基于当前时间,该时间总是在变化)。将序列中的两个连续数字相乘会产生一个不同但同样可预测的数字序列。
关于这是否会减少碰撞,答案是否定的。它实际上会增加碰撞,因为在两个数字相乘的情况下,0 < n < 1。结果将是一个较小的分数,导致结果偏向低端的光谱。
一些进一步的解释。在下面,“不可预测”和“随机”指的是某人根据先前的数字猜出下一个数字的能力。神谕。
给定的种子x,它生成以下值列表:
0.3, 0.6, 0.2, 0.4, 0.8, 0.1, 0.7, 0.3, ...rand()将生成上述列表,rand() * rand()将生成:
0.18, 0.08, 0.08, 0.21, ...这两种方法都会为相同的种子生成相同的数字列表,因此,甲骨文也同样可以预测。但是,如果您查看将这两个调用相乘的结果,您会发现它们都在0.3下,尽管在最初的序列中有一个很好的分布。由于两个分数相乘的影响,这些数字是有偏的。结果的数字总是较小,因此更有可能是碰撞,尽管仍然是不可预测的。
https://stackoverflow.com/questions/3956478
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号