
如何转换大熊猫中的excel数据集?
如何转换大熊猫中的excel数据集?
提问于 2021-08-13 00:54:08
我需要你的小费。我有一个可怕的excel数据集,它有一些问题:
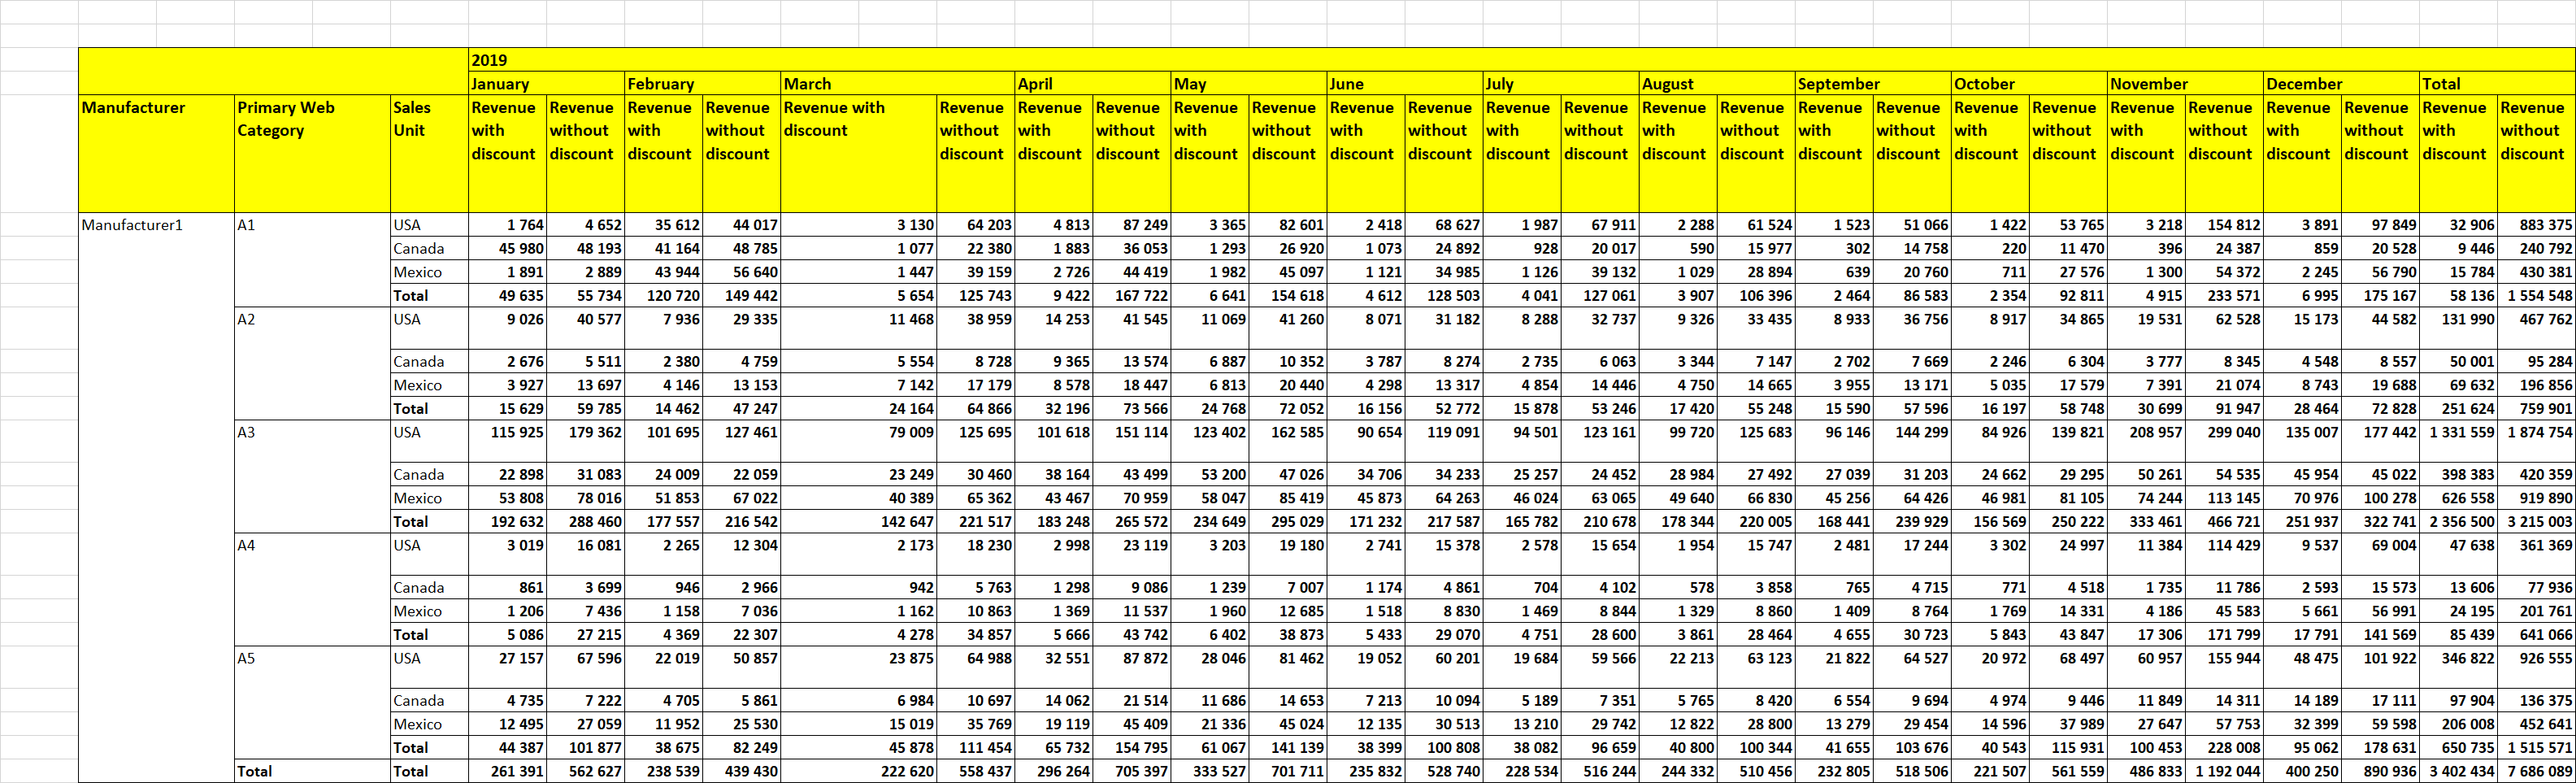
- 开始于第3行和B列
- 列未合并
- I应删除所有“有折扣的收入”,而只留下“收入无折扣”
- I应删除所有行和列“总计”
G 210
简而言之,我应该转换dataset,所以它应该如下所示:
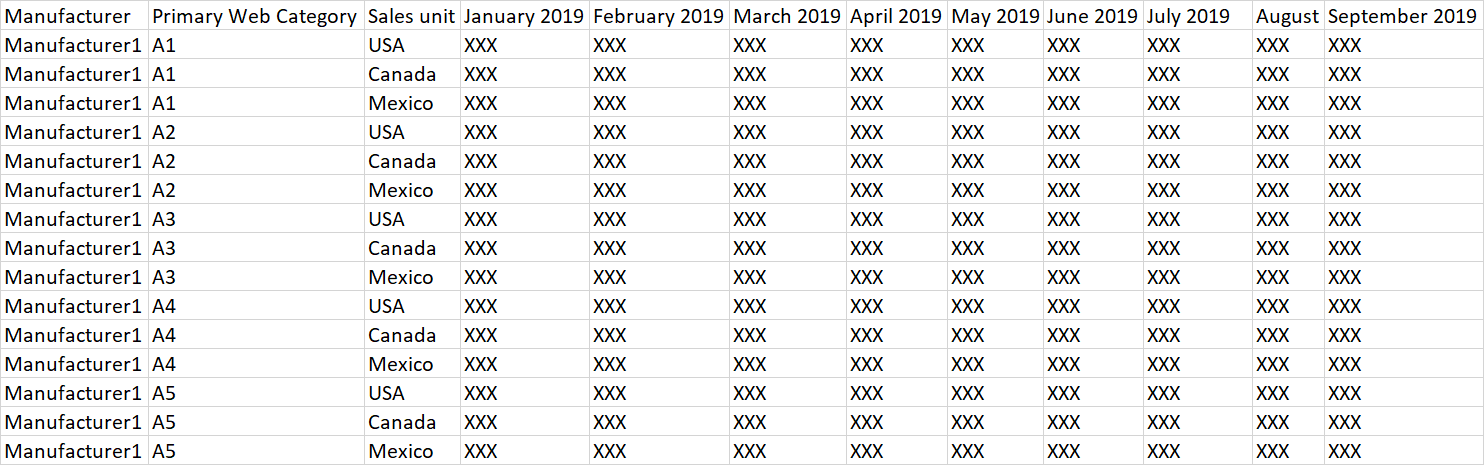
在数据分析中先感谢乞丐:)
附注:对不起,我无法将值上传为表,这就是为什么我会附加图像。
回答 1
Stack Overflow用户
回答已采纳
发布于 2021-08-13 03:22:28
将excel文件读入熊猫数据。使用“header”可以从excel获取所有的多个标头。使用print语句显示列名。
df= pd.read_excel('../../Downloads/Book1.xlsx', header=[0, 1, 2])
print(df.columns)
下面的下一组代码是对列名的一些操作。我们正在迭代以元组格式的上述列多索引名称,并仅从其中解析所需的信息。然后创建新的列名,并将其附加到“cols_required”列表中,并且我们还有多索引列名。
col_names, cols_required = [],[]# initiating empty lists to hold the multiindex names and the new column names
for col in df.columns:
    if 'Unnamed' in str(col[0]) or 'Unnamed' in str(col[1]):# use print statements to see how these tuples look
        cols_required.append(col[2])
        col_names.append(col)
    elif 'with' in str(col[2]) or 'Total' in str(col[1]):
        pass #ignoring columns that have "with","total" in the names
    else:
        cols_required.append(str(col[0])+'_'+str(col[1])+'_'+str(col[2]))
        col_names.append(col)
现在从上面的代码中,我们有了多索引列名和新名称。我们只过滤所需的列,然后分配新的名称。
df = df[col_names]
df.columns = cols_required
df.head()
我使用了provided.Please所使用的确切列名,根据您的需要调整了列名的操作。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/68765655
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号