
使用plotly.py生成带组的图表时X轴上的值顺序错误
数据中的行由三列组成:版本、配置和值。我希望有两行表示我的图表上的配置,以显示版本(x轴)上的值依赖性(y轴)。只要每个配置(组)在x轴上都有相同的值集,一切都是完美的:
import plotly.express as px
import pandas

rows = [
    ['1',  'a', 4],
    ['1',  'b', 3],
    ['2',  'a', 6],
    ['2',  'b', 3],
    ['3',  'a', 6],
    ['3',  'b', 7],
]

df = pandas.DataFrame(columns=['version', 'config',  'value'],
                        data=rows)

fig = px.line(df,
            x='version',
            y='value',
            color='config',
            line_group='config'
            )

fig.write_html("charts.html")当一个类别在x轴上没有某些值时,问题就开始了:
rows = [
    ['1',  'a', 4],
    ['1',  'b', 3],
    # ['2',  'a', 6],
    ['2',  'b', 3],
    ['3',  'a', 6],
    ['3',  'b', 7],
]如您所见,我们在图表上有错误的版本:charts.html
这里的问题是,我们根据输入数据中的第一类对x轴上的值排序(在我们的例子中是a)。例如,当从b类别中删除行时,我看到了正确的顺序。
在我的示例中,使用字符串作为基本版本,一个数字版本只是为了示例的简单性。
问题是如何根据所有类别中的值对x轴排序?
回答 2
Stack Overflow用户
发布于 2021-07-12 16:00:37
我的解决方案是使用category_orders参数:
fig = px.line(df,
            x='version',
            y='value',
            color='config',
            line_group='config',
            category_orders={'version': df["version"]}
            )
category_orders覆盖默认类别排序行为,即使用数据在输入中出现的顺序。category_orders接受一个dict,其键是要重新排序的列名,其值是按所需顺序排列的值列表。这些顺序随处可见:在传说中,在轴上,在条形堆中,按面顺序,按动画帧的顺序等等。
Stack Overflow用户
发布于 2021-07-12 13:48:07
在谷歌Colab笔记本中运行您的代码,这将创建具有正确排序轴的结果图表。
结果图表:
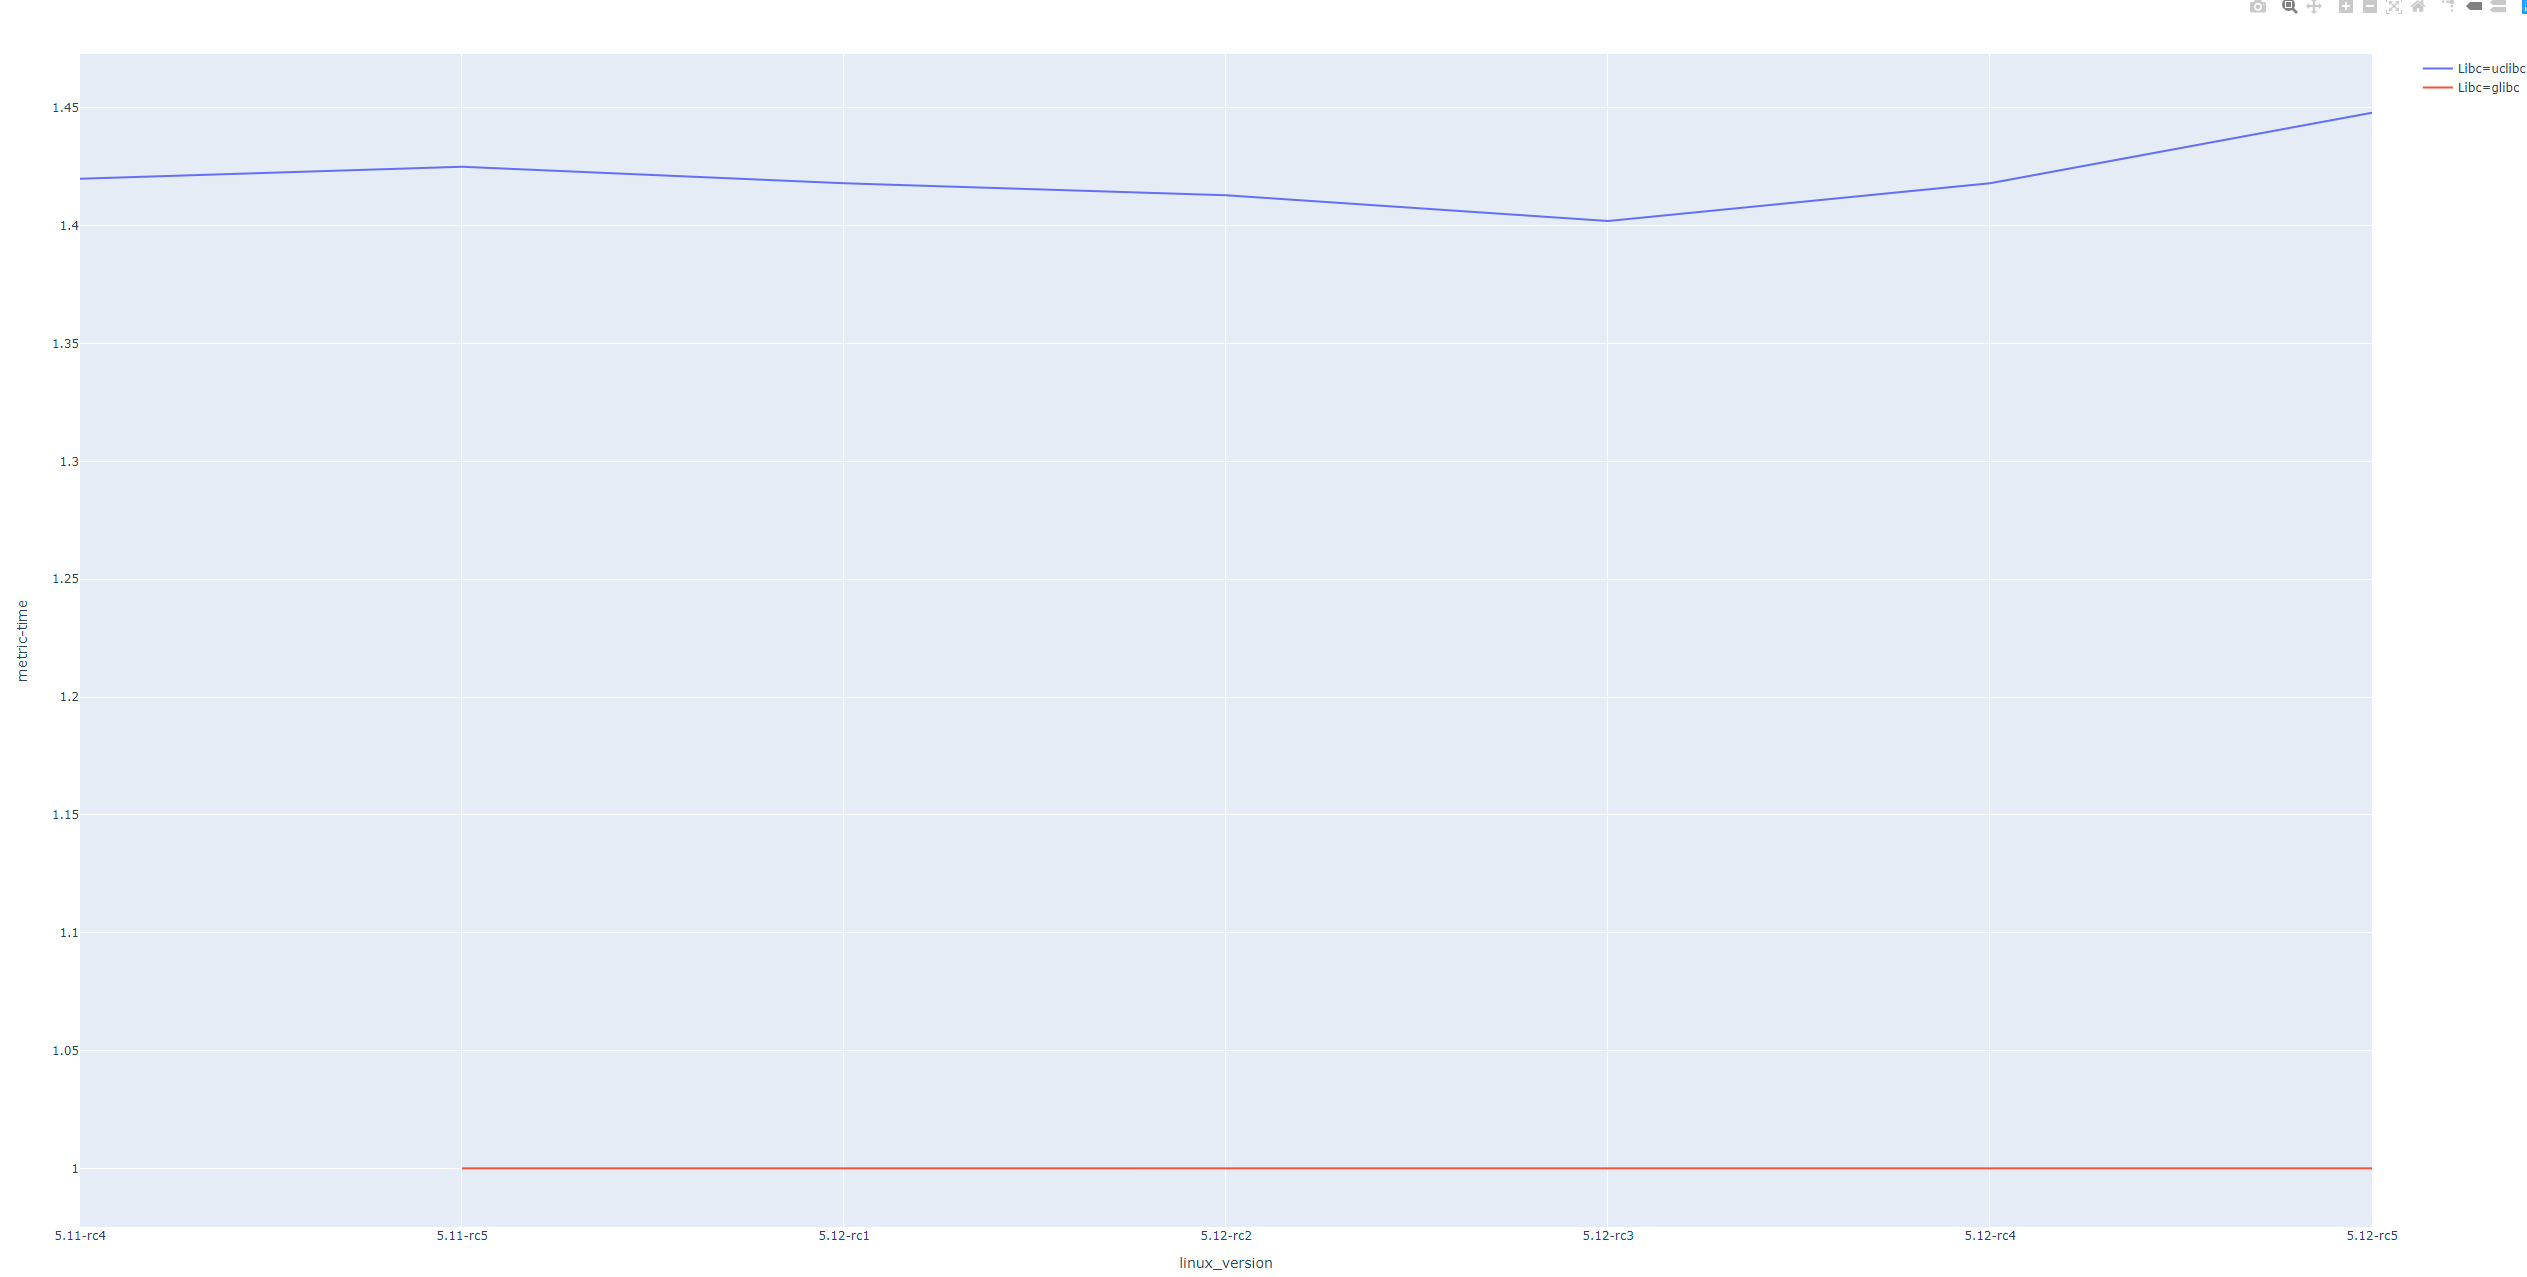
我认为这是由一揽子差异造成的。这是我的colab笔记本电脑为进口的包准备的:
pandas                        1.1.5
pandas-datareader             0.9.0
pandas-gbq                    0.13.3
pandas-profiling              1.4.1
plotly                        4.4.1
也许试着在Colab中运行您的代码,或者确保包版本匹配,我认为最有可能的罪魁祸首是平淡的版本。
https://stackoverflow.com/questions/68348141
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号